


Prioriteit bij storingen voor technische leidinggevenden: snel toepasbare matrix
Prioriteit bij storingen bepaal je door impact en urgentie te combineren: gebruik meteen een matrix en wijs een incident-eigenaar toe. Impact meet je aan bedrijfsschade, urgentie aan de snelheid waarmee die schade groeit. Volgens de ITIL-aanpak leg je severity- en priorityniveaus vooraf vast, zodat je team tijdens de storing beslist op basis van een afspraak en niet op onderbuikgevoel.
Kort samengevat:
- De matrix kent vier impactniveaus en vijf urgentieniveaus; elke combinatie krijgt een prioriteitslabel, van directe escalatie tot afhandeling tijdens de volgende reguliere ronde.
- Stem de grenzen af op contractuele responstijden en leg vast wie uitzonderingen mag maken, bijvoorbeeld bij dreigende reputatieschade ondanks beperkte technische impact.
- Registreer per incident de getroffen diensten, impact, urgentie, contactpersonen en geldende afspraken, en wijs één eigenaar aan in plaats van een hele groep.
- Automatisering mag prioriteiten voorstellen, meldingen versturen en tickets routeren, maar medewerkers moeten kunnen corrigeren; leg uitzonderingen vast in een controleerbaar logboek.
- Oefen incidentrespons minstens jaarlijks en bewaar bellijsten en escalatieschema’s offline, omdat digitale systemen juist tijdens een grote storing kunnen uitvallen.
Inhoudsopgave
- Waarom je impact en urgentie los beoordelen
- Een kopieerbare matrix voor impact en urgentie
- Het triageproces van melding tot evaluatie
- Automatisering slim inzetten zonder de controle te verliezen
- Hoe NLXS prioritering in de praktijk toepast
- Prioriteren is een leiderschapsvraagstuk, geen technisch trucje
- Hoe NLXS je helpt bij prioritering en storingsbeheer
- Veelgestelde vragen
- Bronnen
Waarom je impact en urgentie los beoordelen
Veel teams prioriteren op gevoel: wie het hardst roept, krijgt aandacht als eerste. Dat werkt averechts zodra je meerdere incidenten tegelijk hebt. Door impact en urgentie apart te scoren, dwing je jezelf tot een onderbouwde keuze.
Impact gaat over de omvang van de schade:
- Aantal getroffen gebruikers of klanten en welke kritieke bedrijfsprocessen stilliggen.
- Financiële gevolgen, zoals omzetverlies per uur of contractuele boetes.
- Compliance- en veiligheidsrisico’s, bijvoorbeeld een datalek of een onveilige werkplek.
Urgentie gaat over tempo: hoe snel neemt de schade toe als je niets doet? De ITIL-samenvatting noemt expliciet dat je bij de impactbeoordeling het aantal getroffen gebruikers, processen, financiële gevolgen, security- en compliancerisico’s én SLA’s samen moet wegen. Een storing in een intern testsysteem heeft vaak hoge impact maar lage urgentie: vervelend, maar je hebt dagen de tijd. Een korte uitval van je betaalsysteem tijdens Black Friday is het omgekeerde: de impact per minuut is beperkt, maar de urgentie is torenhoog omdat elke minuut omzet wegvloeit.
Een kopieerbare matrix voor impact en urgentie
Een matrix werkt alleen als iedereen dezelfde definities gebruikt. De NCSC-richtlijnen voor het oefenen van cyberincidenten beschrijven een matrix met vier impactniveaus (extensive, significant, moderate, minor) en vijf urgentieniveaus (critical, high, medium, low, lowest), waarbij elke combinatie naar een prioriteitslabel leidt. Je kunt deze structuur direct overnemen:
- Extensive + critical wordt highest: meteen escaleren en iedereen aan tafel.
- Significant + high wordt high: snelle opvolging binnen het bestaande team.
- Moderate + medium wordt medium: inplannen binnen de dienst, geen nachtoproep.
- Minor + lowest wordt lowest: oppakken in de volgende reguliere ronde.
Atlassian beschrijft hoe je dit in een ticketsysteem inricht: vaste keuzelijsten voor “impact” en “urgency” die samen automatisch een priorityveld vullen. Dat voorkomt discussie tijdens de storing zelf.
Kalibratie is minstens zo belangrijk als de matrix. Pas de grenzen aan op je eigen SLA’s: een webshop stelt andere eisen aan “critical” dan een intern HR-systeem. Leg vast wie uitzonderingen mag maken, bijvoorbeeld wanneer een technisch kleine storing toch grote reputatieschade kan opleveren. Beperk dat mandaat tot de incidentmanager of een vooraf aangewezen leidinggevende, zodat het label betrouwbaar blijft.
Het triageproces van melding tot evaluatie
Een matrix is nuttig, maar pas waardevol binnen een vast proces. Dat proces volgt doorgaans deze stappen:
- Detecteren: monitoring of een melding signaleert de storing.
- Registreren: elk incident krijgt een ticket met tijdstip en melder.
- Categoriseren: welk systeem of welke dienst is geraakt?
- Prioriteren: impact en urgentie scoren via de matrix.
- Toewijzen: een eigenaar krijgt het incident, geen groepsverantwoordelijkheid.
- Escaleren: bij “highest” of “high” gaat het mandaat omhoog.
- Oplossen: de technische fix wordt doorgevoerd.
- Herstellen: diensten worden volledig teruggezet, inclusief verificatie.
- Afsluiten en evalueren: een korte evaluatie legt vast wat beter kan.
Leg bij intake altijd dezelfde gegevens vast: getroffen diensten, geschatte impact, urgentie, contactpersonen en de geldende SLA. De NCSC-richtlijn voor 24/7 support benadrukt dat rollen en afspraken met leveranciers vooraf moeten vaststaan, inclusief wie mag besluiten tot brede communicatie of het stilleggen van productie. Zonder die afspraak ontstaat tijdens een incident discussie over mandaat, terwijl de klok doortikt.
Pro-tip: Leg escalatiemandaten schriftelijk vast in je IT-continuïteitsplan, zodat niemand tijdens een storing hoeft te gokken wie mag beslissen.
Automatisering slim inzetten zonder de controle te verliezen
Automatisering versnelt triage aanzienlijk, maar mag nooit blind beslissen. De NCSC-richtlijn stelt dat classificatie ondersteunend moet blijven: het systeem stelt een prioriteit voor, een medewerker corrigeert waar nodig, en elke uitzondering komt in een auditlog terecht.
Onderdelen die zich goed lenen voor automatisering:
- Een voorgestelde prioriteit op basis van vooraf ingestelde impact- en urgentiewaarden.
- Automatische notificaties en paging naar de juiste on-call engineer.
- Routing van het ticket naar de eigenaar van het getroffen systeem.
Een praktische regel: als impact op “extensive” staat en urgentie op “critical”, stuurt het systeem direct een paging naar de dienstdoende engineer en informeert het de incidentmanager. Governance blijft daarbij verplicht: menselijke override, een zichtbaar auditlog en een vastgelegde procedure voor uitzonderingen. Zonder die drie wordt automatisering een risico in plaats van een versnelling.
Hoe NLXS prioritering in de praktijk toepast
We gebruiken vooraf ingestelde prioriteitsregels en automatische meldingen om onze engineers direct op het juiste incident te zetten.
Onze ervaring leert dat de meeste vertraging niet in de techniek zit, maar in onduidelijkheid over wie beslist. Door dat mandaat vooraf vast te leggen, lossen we storingen sneller op en houden we zicht op wat er gebeurt. Meer over onze aanpak en responstijden lees je op onze pagina over storingsoplossing.
Prioriteren is een leiderschapsvraagstuk, geen technisch trucje
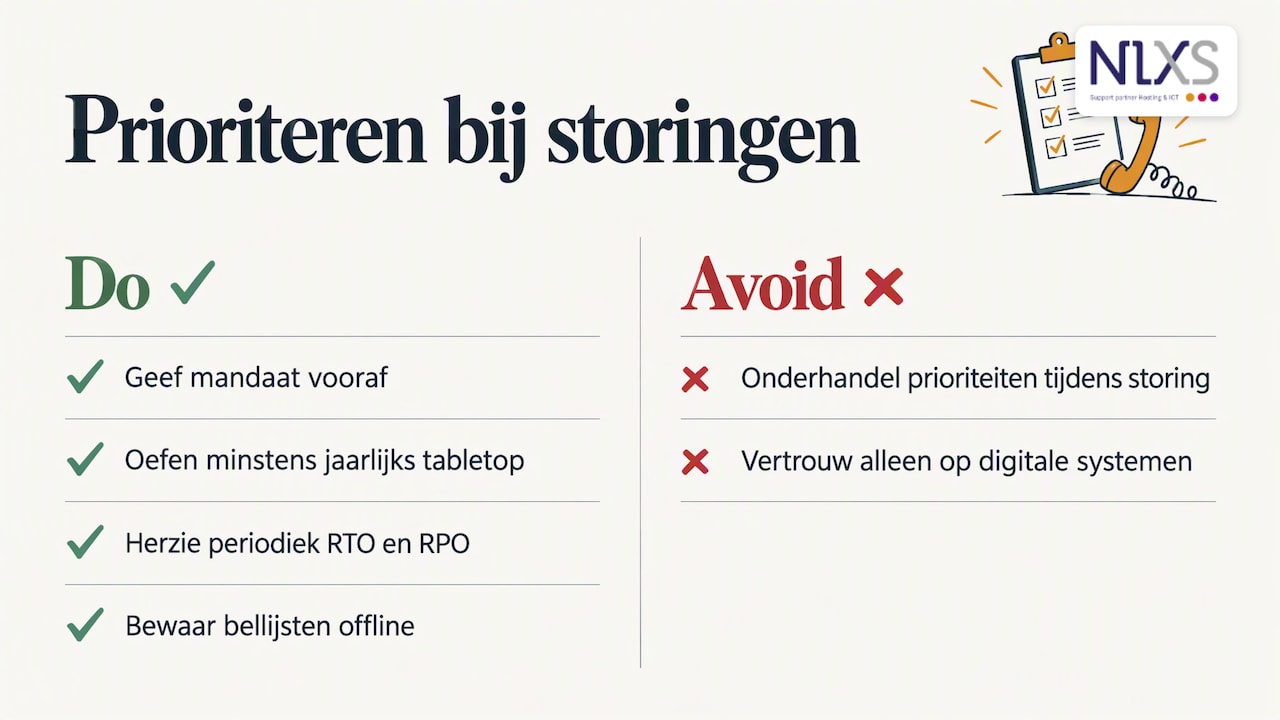
De matrix is het makkelijke deel. Het moeilijke deel is dat teams tijdens een piekincident durven vasthouden aan de afgesproken prioriteit, ook als een directielid iets anders “het belangrijkste” noemt. Dat vraagt mandaat dat vooraf is gegeven, niet onderhandeld tijdens de storing.
Oefen daarom minstens jaarlijks met een tabletopoefening en herzie periodiek je RTO en RPO. Bewaar bellijsten en escalatieschema’s ook offline: digitale systemen zijn precies wat uitvalt tijdens een grote storing.
— Ken
Hoe NLXS je helpt bij prioritering en storingsbeheer
We begrijpen dat een matrix pas waarde heeft als er een team achter staat dat snel handelt. Daarom combineren we hosted serverbeheer met directe telefonische bereikbaarheid en oplossing van problemen binnen één dag, zonder onduidelijke kostenstructuren.

Onze beheerabonnementen omvatten monitoring, automatische melding van storingen en vaste aanspreekpunten met duidelijk mandaat. Voor bedrijven die risico’s breder willen afdekken, is een cyberverzekering een zinvolle aanvulling op technische maatregelen. Wil je weten hoe je eigen prioriteitsproces ervoor staat? Vraag een ICT-scan aan via onze pagina voor managed ICT-diensten en we denken vrijblijvend met je mee.
Veelgestelde vragen
Wat betekent prioriteit precies bij een storing?
Prioriteit is de combinatie van impact, het effect op bedrijfsprocessen, en urgentie, de snelheid waarmee de schade toeneemt. Door beide apart te scoren en te combineren in een matrix, bepaal je objectief welk incident als eerste aandacht krijgt.
Hoe stel je impact en urgentie vast tijdens een storing?
Impact bepaal je aan de hand van het aantal getroffen gebruikers, kritieke processen, financiële gevolgen en compliance-risico’s. Urgentie bepaal je aan de snelheid waarmee die schade toeneemt, vaak afgezet tegen je vastgestelde RTO en RPO.
Mag automatisering de prioriteit van een storing zelf bepalen?
Automatisering mag een prioriteit voorstellen en notificaties versturen, maar een medewerker moet uitzonderingen kunnen corrigeren. De NCSC-richtlijn stelt menselijk toezicht en een auditlog als voorwaarde voor verantwoorde classificatie.
Welke rol spelen SLA’s bij het bepalen van prioriteit?
Een SLA stelt vaste responstijden per prioriteitsniveau vast, zodat teams weten binnen welke termijn een “highest” of “medium” incident moet zijn opgepakt. De matrixgrenzen kalibreer je op die SLA’s, zodat labels aansluiten bij wat contractueel is afgesproken.
Hoe vaak moet je incidentrespons oefenen?
Een tabletopoefening minstens eenmaal per jaar helpt om ontbrekende contactgegevens en onduidelijke mandaten op tijd te ontdekken. De NCSC-richtlijn voor voorbereiding op cyberincidenten adviseert daarnaast periodiek back-ups te testen op daadwerkelijk herstel.
Bronnen
- NCSC — hoe oefen je voor een cyber-incident
- Atlassian Support — create an impact urgency priority matrix
- ITIL-georiënteerde incidentmanagement samenvatting
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.