


Patchmanagementbeleid opstellen: van sjabloon naar audit-proof beleid
Stel een formeel patchmanagementbeleid vast met gedefinieerde rollen, SLA’s per urgentieklasse en een getest rollback-plan binnen een praktische termijn. Dit artikel geeft je een direct te downloaden sjabloon, een zeven-stappen checklist en een implementatieproces dat in één tot enkele maanden operationeel staat. De opzet leunt op het NCSC-implementatieplan en de BIR-richtlijnen, zodat je beleid ook bij een audit overeind blijft.
Kort samengevat:
- Kritieke kwetsbaarheden moeten binnen één week worden gepatcht, waarbij logs en changetickets vanaf dag één worden bijgehouden.
- Een effectief patchmanagementbeleid omvat scope, rollen, SLA’s, inventarisatiestandaarden en uitzonderingsprocedures, die allemaal aantoonbaar moeten zijn voor audits.
- Automatisering van inventarisatie, scanning en patching is essentieel, vooral voor kernsystemen en standaardconfiguraties bij kleine organisaties.
- Het uitvoeren van testen en rollback-plannen voorkomt systeemuitval en versterkt het vertrouwen in het patchproces.
- Het beleid moet minimaal jaarlijks worden herzien en voorzien zijn van gedocumenteerde rapportages, logs en goedkeuringsprocedures om audit-proof te blijven.
Inhoudsopgave
- Snelle checklist: patch management beleid in 7 stappen
- De kernonderdelen van een patchmanagementbeleid
- Hoe voer je het patchmanagementproces stap voor stap uit?
- Welke SLA’s horen bij welke patchprioriteit?
- Hoe richt je testen en rollback in voor patches?
- Governance: hoe blijft je beleid audit-proof?
- Sjabloon en voorbeeldbeleid: hoe pas je het toe?
- Waarom NLXS dit document aanbeveelt
- Patchbeheer uitbesteden aan NLXS: hoe werkt dat?
- Bronnen
- Veelgestelde vragen
Snelle checklist: patch management beleid in 7 stappen
Wil je vandaag nog beginnen? Doorloop deze zeven stappen in volgorde, want elke stap bouwt voort op de vorige.
- Inventariseer je assets. Leg vast welke systemen, servers en applicaties onder het beleid vallen, inclusief eigenaarschap.
- Wijs rollen toe. Benoem een CISO of security manager en koppel elk asset aan een systeem of asset-eigenaar.
- Classificeer patches. Verdeel updates in kritiek, hoog, midden en laag, met een vaste SLA per klasse.
- Richt een testring in. Bepaal welke systemen eerst een patch krijgen voordat je breed uitrolt.
- Documenteer een rollback-plan. Zorg dat elke patch een terugdraaiscenario heeft, inclusief backup-vereisten.
- Koppel patchbeheer aan changemanagement. Elke patch krijgt een ticket, ook bij spoedprocedures.
- Rapporteer maandelijks. Meet compliance-percentage en openstaande patches als vast agendapunt.
Voor kritieke kwetsbaarheden geldt een korte doorlooptijd. De BIR adviseert patching van zeer kritieke lekken binnen één week na publicatie. Zorg dat je vanaf dag één logs en changetickets bijhoudt, want dat bewijsmateriaal vraagt elke auditor als eerste op.
De kernonderdelen van een patchmanagementbeleid
Een patchmanagementbeleid dat standhoudt bij een audit bevat vijf vaste onderdelen. Mis je er één, dan valt het beleid terug op losse afspraken die niemand kan aantonen.
- Scope en assetdefinitie. Beschrijf letterlijk wat binnen het beleid valt: werkstations, servers, netwerkapparatuur, cloudinstanties en eventueel IoT-apparatuur. Sluit bewust uit wat buiten scope valt, zoals persoonlijke apparatuur van medewerkers, en leg dat vast.
- Rollen en verantwoordelijkheden. De CISO stelt het beleid vast en bewaakt naleving. De systeem of asset-eigenaar voert patches daadwerkelijk uit of geeft opdracht daartoe, en tekent voor uitzonderingen. Een aparte changemanager beoordeelt de impact van patches op productieomgevingen.
- Patchclassificatie en SLA-koppeling. Koppel elke kwetsbaarheidsscore aan een concrete tijdlijn. Een kritieke kwetsbaarheid met actief misbruik krijgt een andere behandeling dan een routinematige beveiligingsupdate.
- Inventarisatiestandaarden. Leg voor elk asset minimaal vast: besturingssysteem, versienummer, laatste patchdatum, eigenaar en kritikaliteit voor de bedrijfsvoering. Zonder die metadata kun je nooit onderbouwen waarom een systeem wel of niet snel gepatcht is.
- Uitzonderingsprocedure. Legacy-systemen en apparatuur die een leverancier niet meer patcht, vragen een formele uitzondering met een tijdelijke mitigatie, zoals netwerksegmentatie of extra monitoring. Documenteer wie de uitzondering goedkeurt en wanneer die wordt herzien.
Een beleid zonder afdwingingsmechanisme vervalt in de praktijk tot een papieren document dat niemand naleeft. Rollen, meetbare SLA’s en automatisering zijn geen bijzaak, maar de kern van een werkend patchmanagementproces. Sectoren met strengere eisen, zoals de zorg, moeten daarbovenop rekening houden met NEN 7510, die een formele, risicogebaseerde aanpak met strikte termijnen voor kritieke patches verplicht stelt.
Hoe voer je het patchmanagementproces stap voor stap uit?
Een beleid op papier is nog geen werkend proces. Onderstaande fasering laat zien wie wat doet en wanneer je resultaat mag verwachten.
- Fase 1: inventarisatie (week 1 tot 2). De systeembeheerder brengt alle assets in kaart met een tool voor endpoint-detectie of een assetmanagementsysteem. Deliverable: een actuele asset-lijst met eigenaarschap en kritikaliteit.
- Fase 2: identificatie van kwetsbaarheden (doorlopend). Koppel een scanner of vendor-advisory-feed aan je inventarisatie zodat nieuwe kwetsbaarheden automatisch worden gesignaleerd. Deliverable: een wekelijks overzicht van openstaande kwetsbaarheden per asset.
- Fase 3: prioritering (doorlopend). De CISO of security manager beoordeelt elke kwetsbaarheid op basis van kritikaliteit, exploiteerbaarheid en bedrijfsimpact. Deliverable: een geprioriteerde patchlijst met SLA-datum.
- Fase 4: testen (per patchronde). Rol de patch eerst uit naar een beperkte testring van niet-kritieke systemen. Deliverable: een testrapport met go/no go-besluit.
- Fase 5: implementatie (per patchronde). Na goedkeuring volgt brede uitrol, buiten kantooruren waar mogelijk, met een vooraf gepland terugvalmoment. Deliverable: een uitrolrapport per systeemgroep.
- Fase 6: verificatie (direct na uitrol). Controleer of de patch daadwerkelijk is toegepast en of systemen stabiel draaien. Deliverable: een verificatielog per asset.
- Fase 7: rapportage (maandelijks). Verzamel compliance-cijfers, doorlooptijden en openstaande items in een vast rapport voor management en auditors. Deliverable: een maandrapport patchstatus.
Automatisering is hier geen luxe maar noodzaak. Het NCSC-implementatieplan adviseert kleinere organisaties om te starten met een basisinventaris en geautomatiseerde patching van besturingssystemen en veelgebruikte applicaties, en pas daarna complexere endpoints en uitzonderingen op te nemen. Dat voorkomt dat je vastloopt in een project dat nooit klaar is.
Pro-tip: Plan je eerste volledige patchronde niet breder dan één systeemgroep. Een succesvolle pilot op bijvoorbeeld alle Windows-werkstations levert sneller vertrouwen op bij management dan een ambitieuze uitrol die meteen vastloopt op een uitzondering.
Realistisch gezien staat een MKB-organisatie met een aangewezen systeembeheerder binnen enkele weken op een werkend basisproces: inventarisatie, classificatie en geautomatiseerde patching van kernsystemen. Volledige dekking, inclusief uitzonderingen en legacy-apparatuur, vraagt meestal een paar maanden. Wie de eigen capaciteit mist, kan dit proces ook via managed services laten inrichten, zodat de opstartfase niet blijft hangen op interne prioriteiten.
Welke SLA’s horen bij welke patchprioriteit?
Een SLA zonder rationale is een schot in het duister. Koppel elke tijdlijn aan een concrete risico-inschatting, niet aan een gevoel van urgentie.
| Urgentieklasse | Voorbeeldcriterium | Aanbevolen tijdlijn |
|---|---|---|
| Kritiek | Actief misbruikte kwetsbaarheid, kritieke systemen | Binnen 1 week |
| Hoog | Hoge CVSS-score, geen bekend misbruik | Binnen 2 tot 4 weken |
| Midden | Reguliere beveiligingsupdate | Binnen 1 patchcyclus (meestal maandelijks) |
| Laag | Functionele update, geen beveiligingsrisico | Volgende geplande onderhoudsronde |
Cijfers die het verschil maken: de BIR adviseert een doorlooptijd van maximaal één week voor zeer kritieke kwetsbaarheden, terwijl CISA’s catalogus van actief misbruikte kwetsbaarheden precies aangeeft welke lekken die urgentie verdienen. Zonder die feed prioriteer je op onderbuikgevoel in plaats van op werkelijk risico.
Meet niet alleen of een patch is toegepast, maar ook hoe lang dat duurde. Rapporteer per klasse het percentage patches dat binnen de afgesproken tijdlijn is uitgevoerd, en houd het aantal openstaande kritieke patches ouder dan de SLA-termijn zichtbaar. Die twee cijfers zeggen auditors en management meer dan een algemeen compliancepercentage.
Hoe richt je testen en rollback in voor patches?
Een patch die een productiesysteem platlegt, kost meer vertrouwen dan een kwetsbaarheid die twee weken langer open blijft. Testen en rollback zijn daarom geen formaliteit, maar de kern van een veilig patchproces.
- Richt een testring in met representatieve, niet-kritieke systemen die dezelfde configuratie hebben als productie.
- Voer een regressietest uit op kernfunctionaliteit voordat je een patch breed uitrolt.
- Maak vóór elke patchronde een backup of snapshot van kritieke systemen, zodat herstel binnen minuten mogelijk is.
- Leg rollback-criteria vooraf vast: bij welke foutmelding of prestatieverlies trek je de patch terug?
- Wijs één beslisser aan voor het noodprotocol, meestal de systeembeheerder in overleg met de CISO.
Spoedpatches, bijvoorbeeld bij een kwetsbaarheid die al actief wordt misbruikt, volgen een verkort proces: minder uitgebreid testen, maar wel een verplichte rollback-check en directe koppeling met incidentrespons. Rollback-procedures die vooraf zijn vastgelegd, voorkomen paniek op het moment dat een patch daadwerkelijk faalt.
Pro-tip: Test rollback niet alleen op papier. Oefen minstens één keer per jaar een daadwerkelijke terugdraai op een testomgeving, zodat je weet of je backup-strategie ook echt binnen de afgesproken tijd werkt. Een goede back-upstrategie is de ruggengraat van elk rollback-plan; bekijk welke aanpak past bij jouw organisatie voordat je het patchbeleid vaststelt.
Governance: hoe blijft je beleid audit-proof?
Een patchmanagementbeleid is geen eenmalig document, maar een levend stuk governance dat je periodiek herziet en waarvan je de uitvoering aantoonbaar maakt.
- Rapporteer maandelijks compliance-percentage, apply-successratio en het aantal openstaande kritieke items aan management.
- Herzie het beleid minimaal jaarlijks, of direct na een grote wijziging in infrastructuur of dreigingsbeeld.
- Voer versiebeheer op het beleidsdocument zelf: elke wijziging krijgt een datum, auteur en reden.
- Bewaar changetickets, patchlogs en testrapporten minimaal zo lang als je compliance-kader vereist.
- Zorg dat elk uitzonderingsdossier terug te vinden is met goedkeuring en herzieningsdatum.
Auditors vragen zelden alleen om het beleidsdocument. Ze willen logs zien die aantonen dat de SLA’s ook echt gehaald zijn, en changetickets die laten zien dat elke patch een besluitvormingsspoor heeft. Goede technische documentatie maakt dat aantoonbaar; zorgvuldige hostingdocumentatie is daarbij net zo relevant als het patchlogboek zelf.
Sjabloon en voorbeeldbeleid: hoe pas je het toe?
Een kant-en-klaar sjabloon voor patch- en kwetsbaarhedenbeheer, zoals dat van The Trusted Third Party, bevat doorgaans al de basisstructuur voor scope, rollen, classificatie en rapportage. Jouw werk is het invullen van de organisatiespecifieke velden.
- Vul de assetlijst en eigenaarschap in op basis van je eigen inventarisatie.
- Benoem concrete namen of functies bij elke rol, niet alleen abstracte titels.
- Stel je eigen SLA-tijdlijnen vast, afgestemd op sector en compliance-eisen.
- Voeg je uitzonderingsregister toe met actuele legacy-systemen.
- Koppel het sjabloon aan je bestaande changemanagementproces.
| Sjabloononderdeel | Wat je invult | Klaar binnen |
|---|---|---|
| Scope en assets | Systemen, eigenaarschap, kritikaliteit | Week 1 tot 2 |
| Rollen | Namen, functies, autorisaties | Week 1 tot 2 |
| SLA-tijdlijnen | Klassen en doorlooptijden per risiconiveau | Week 2 tot 3 |
| Test en rollback | Testring, backup-eisen, criteria | Week 3 tot 4 |
| Rapportage | KPI’s, reviewcyclus, versiebeheer | Week 4 tot 6 |
Doorloop deze checklist voordat je het beleid vaststelt: staan alle rollen op naam, is de SLA-tabel compleet, is er een getest rollback-scenario en is er een reviewdatum vastgelegd? Zonder die vier vakjes aangevinkt is het beleid nog niet audit-proof.
Waarom NLXS dit document aanbeveelt
Een goed patchmanagementbeleid lost niets op zonder discipline in de uitvoering. Wij zien bij klanten zoals TU Eindhoven en JCI Breda dat de grootste faalfactor niet het beleid zelf is, maar het gebrek aan tijd om het structureel te blijven uitvoeren.
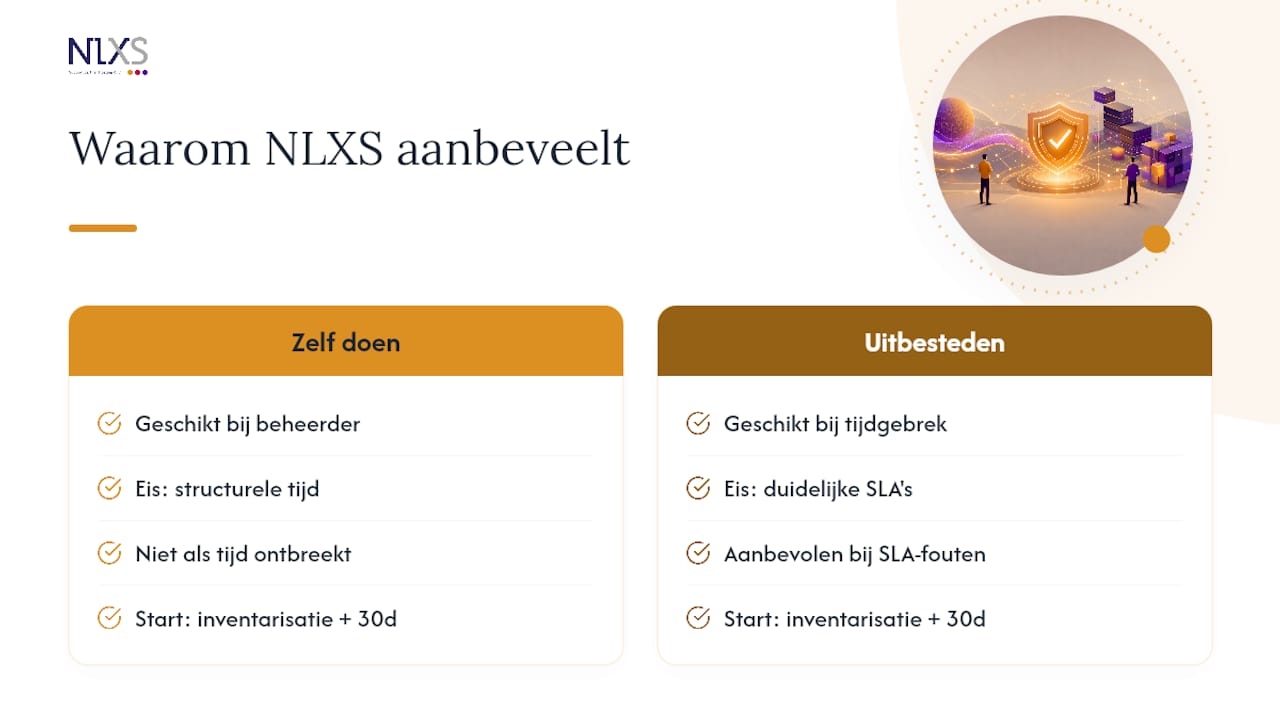
Zelf doen werkt wanneer je een aangewezen systeembeheerder hebt die structureel tijd krijgt voor patchcycli en rapportage. Uitbesteden is verstandig wanneer patchen naast andere taken blijft liggen, of wanneer je merkt dat SLA’s stelselmatig niet gehaald worden. Elke samenwerking begint met een concrete inventarisatie en een helder overzicht van wat de eerste 30 dagen opleveren, zonder verrassingen in scope of kosten achteraf.
— Ken
Patchbeheer uitbesteden aan NLXS: hoe werkt dat?
Een beleid opstellen is één stap. Het dagelijks uitvoeren, testen en rapporteren is een andere. Dit is een alternatief voor organisaties die geen eigen systeembeheerder hebben die dit structureel kan bijhouden: technische problemen worden doorgaans binnen één dag opgelost, terwijl veel andere partijen met langere responstijden werken.

Onze managed services nemen inventarisatie, patchclassificatie en rapportage over, zodat jouw team zich op de eigen kernactiviteiten kan richten. Twijfel je of je huidige ICT-omgeving al aan de basisvoorwaarden voldoet? Vraag een gratis ICT-scan aan en krijg binnen enkele dagen een concreet beeld van risico’s en verbeterpunten, zonder verplichtingen en zonder verrassingen in de facturering achteraf. Neem contact met ons op om je eerste patchronde samen op te zetten.
Bronnen
- NCSC – Patchmanagement implementatieplan v1.1
- BIR – Patch management uitgangspunten
- Sjabloon voor patch- en kwetsbaarhedenbeheer – The Trusted Third Party
- Kaseya – Het patchbeheerproces: een stapsgewijze handleiding
Veelgestelde vragen
Wat is patch management?
Patch management is het proces waarmee organisaties software-updates identificeren, testen en installeren om bekende kwetsbaarheden te dichten. Het omvat inventarisatie, classificatie, testen, uitrol en rapportage, vastgelegd in een patchmanagementbeleid.
Wat zijn de drie soorten patches?
De meest gebruikte indeling is beveiligingspatches, die kwetsbaarheden dichten; bugfixes, die fouten in software herstellen; en functionele updates, die nieuwe mogelijkheden toevoegen. Beveiligingspatches krijgen in vrijwel elk patchmanagementbeleid de kortste doorlooptijd, zoals het BIR-advies van één week voor kritieke lekken laat zien.
Wat betekent een patch?
Een patch is een softwareupdate die een specifiek probleem oplost, meestal een beveiligingslek, een fout of een compatibiliteitsprobleem. Leveranciers publiceren patches vaak los van grote versie-updates, zodat organisaties snel kunnen reageren op nieuwe kwetsbaarheden.
Hoe stel ik een patchmanagementbeleid op zonder eigen IT-afdeling?
Begin met een basissjabloon dat scope, rollen en SLA’s al bevat, en vul dit aan met je eigen assetlijst en eigenaarschap. Organisaties zonder eigen systeembeheerder kunnen dit proces ook via managed services van NLXS laten inrichten en uitvoeren.
Hoe vaak moet je het patchbeleid herzien?
Herzie het beleid minimaal jaarlijks, en direct na een grote wijziging in infrastructuur, compliance-eisen of dreigingsbeeld. Versiebeheer op het document zelf, met datum en reden van wijziging, is een vast onderdeel van audit-bewijsvoering.
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.