


MySQL prestatieoptimalisatie begint met meten en EXPLAIN ANALYZE
Meet eerst; los daarna de top-killers op: indexen en queries. Pas als die klaar zijn, kijk je naar servervariabelen. Gebruik de slow query log en Performance Schema om de duurste queries te vinden, herschrijf ze met hulp van EXPLAIN en EXPLAIN ANALYZE, en fix indexproblemen voordat je aan configuratie sleutelt. Daarna pas je de InnoDB buffer pool aan op basis van je werkelijke werkset en verifieer je het resultaat met buffer-pool metrics.
Kort samengevat:
- Het activeren van de slow query log en het analyseren van de top tien langzame queries biedt directe winst door de belasting en inefficiënties te identificeren.
- Het gebruik van EXPLAIN en EXPLAIN ANALYZE helpt om de werkelijke oorzaak van trage queries te achterhalen en gerichte indexaanpassingen mogelijk te maken.
- Het verwijderen van niet-gebruikte indexen na een observatieperiode minimaliseert schrijfoverhead en voorkomt onnodige belasting van de database.
- Het afstemmen van de InnoDB buffer pool op de werkset met behulp van statistieken voorkomt schijfgebruik en verbetert de algehele prestaties.
- Alleen na het optimaliseren van queries en indexen moet je serverconfiguraties zoals I/O-capaciteit en logcapaciteit aanpassen voor maximale efficiëntie.
Inhoudsopgave
- Quick wins: waar zit de snelste winst in mysql performance tuning?
- Hoe vind je de echte bottleneck met de slow query log?
- EXPLAIN en EXPLAIN ANALYZE: hoe lees je een leesplan?
- Welke indexen heb je nodig en welke kun je missen?
- Hoe stem je de InnoDB buffer pool goed af?
- Welke serverconfiguratie en I/O-instellingen tellen het meest?
- Hoe rol je wijzigingen veilig uit en verifieer je het resultaat?
- Wanneer is uitbesteden slimmer dan zelf blijven tunen?
- Beheerde hosting en databasesupport zonder gedoe
- Bronnen
Quick wins: waar zit de snelste winst in mysql performance tuning?
Niet elke ingreep levert evenveel op. Sommige aanpassingen kosten vijf minuten en schelen meteen merkbaar in laadtijd, andere zijn dagenwerk voor een marginaal effect. De volgorde hieronder is gebaseerd op impact per geïnvesteerde minuut.
- Zet de slow query log aan en bekijk de top tien queries op cumulatieve tijd, niet op losse uitschieters. Ervaring uit de praktijk leert dat een handvol queries vaak tachtig procent van de belasting voor zijn rekening neemt.
- Draai EXPLAIN op die top tien en zoek naar
type: ALL(full table scan) ofUsing filesort. Dat zijn de twee grootste rode vlaggen. - Voeg ontbrekende indexen toe waar een scan een index kan vervangen, en verwijder overduidelijk ongebruikte indexen pas na een observatieperiode.
- Herschrijf pagineringsqueries die met een hoge
OFFSETwerken; die scannen bij elke pagina meer rijen dan nodig. - Kijk pas daarna naar buffer pool en I/O-instellingen.
Test elke indexwijziging eerst in een staging-omgeving met een representatieve dataset. Een index die in productie ineens verdwijnt, kan een query die heel snel was in seconden veranderen, en dat merk je meestal pas als klanten al klagen.
Hoe vind je de echte bottleneck met de slow query log?
De slow query log is je startpunt, niet je eindpunt. Zet hem aan met een realistische drempel: begin met long_query_time = 1 (in seconden) op een productiesysteem, en verlaag die naar 0,1 seconde op een testomgeving om ook sluimerende problemen te vangen. Log ook queries zonder index via log_queries_not_using_indexes = ON, al levert dat op een druk systeem snel veel ruis op.
Ruwe logregels zeggen weinig; je moet ze aggregeren. pt-query-digest (uit de Percona Toolkit) of het eenvoudigere mysqldumpslow groeperen queries op patroon en ranken ze op totale tijd, gemiddelde tijd en aantal uitvoeringen. Dat is precies de aanpak die de praktijk aanraadt: meet eerst, analyseer daarna met EXPLAIN, fix vervolgens de query of index, en pas pas als laatste stap serverparameters aan.
Naast de log geeft Performance Schema realtime inzicht via statusvariabelen die je direct kunt bevragen:
Innodb_buffer_pool_readsstijgend over tijd wijst op geheugendruk, niet op een incident.Innodb_buffer_pool_pages_evictedhoog betekent dat data wordt verdrongen voordat die herbruikt kan worden.Rows_examinedversusRows_sentin de slow log toont hoe inefficiënt een query rijen doorzoekt ten opzichte van wat ze daadwerkelijk teruggeeft.
Statistiek om te onthouden: een stijgende trend in disk reads en evictions is een betrouwbaarder signaal dan een hoge hitratio alleen. Een hitratio van 99% zegt niets als het resterende procent toevallig je zwaarste queries treft.
EXPLAIN en EXPLAIN ANALYZE: hoe lees je een leesplan?
EXPLAIN toont het geschatte uitvoeringsplan van de optimizer: welke tabellen, welke indexen, hoeveel rijen naar schatting bekeken worden. EXPLAIN ANALYZE gaat een stap verder: de query wordt daadwerkelijk uitgevoerd en je krijgt de werkelijke tijd per stap en het echte aantal rijen. Dat maakt diagnose een feit in plaats van een educated guess, wat vooral waardevol is na een wijziging, ter verificatie.
Gebruik EXPLAIN eerst, snel en goedkoop, om een eerste beeld te krijgen. Zet EXPLAIN ANALYZE in wanneer je een fix wilt bevestigen of wanneer de schatting van de optimizer verdacht ver van de werkelijkheid lijkt te liggen, wat bij scheve dataverdelingen vaak gebeurt.
Drie patronen kom je voortdurend tegen in EXPLAIN-uitvoer:
type: ALLbetekent een volledige tabelscan. Bijna altijd op te lossen met een passende index op de kolommen in jeWHERE– ofJOIN-clausule.Extra: Using filesortbetekent dat MySQL apart moet sorteren omdat er geen index is die de gevraagde volgorde al oplevert. Een composite index die filter en sorteervolgorde combineert, lost dit meestal op.Extra: Using temporaryduidt op een tijdelijke tabel, vaak bijGROUP BYofDISTINCTzonder ondersteunende index, en is een signaal om de query te herschrijven of de index uit te breiden.
De workflow is steeds hetzelfde: run EXPLAIN, herken het patroon, pas de index of query aan, en bevestig met EXPLAIN ANALYZE dat de werkelijke tijd ook daadwerkelijk daalt. Zonder die laatste stap weet je niet of je fix echt werkt of alleen plausibel klinkt.
Welke indexen heb je nodig en welke kun je missen?
Een index die nooit gelezen wordt, kost alleen maar schrijfoverhead: elke INSERT of UPDATE moet die index ook bijhouden. Veel systemen die jarenlang doorgroeien, verzamelen zulke indexen zonder dat iemand ze durft te verwijderen.
- Inventariseer eerst. Vraag
sys.schema_unused_indexesop om indexen te vinden die sinds de laatste herstart niet gelezen zijn, en combineer dat mettable_io_waits_summary_by_index_usagevoor een vollediger beeld. Dat zijn de officiële audit-mechanismen die de MySQL Reference Manual beschrijft voor indexanalyse. - Controleer composite-index volgorde. De kolom met de hoogste selectiviteit hoort meestal vooraan, en een index die alle gevraagde kolommen dekt (een covering index) voorkomt dat MySQL na de indexlookup nog terug naar de tabel moet.
- Verwijder nooit direct. Maak de index eerst onzichtbaar met
ALTER TABLE ... ALTER INDEX ... INVISIBLE. De index blijft bestaan en onderhouden, maar de optimizer negeert hem. Observeer een representatieve periode, meestal een volledige weekcyclus inclusief piekmomenten, en controleer of query’s alsnog trager worden. Pas dan volgt de definitieveDROP INDEX.
Pro-tip: een onzichtbare index is de goedkoopste verzekering die je hebt. Als een “overbodige” index toch ergens cruciaal blijkt, zet je hem in één statement weer zichtbaar zonder dat je hem opnieuw hoeft op te bouwen.
Voor webshops met veel productfilters en sorteeropties loopt dit probleem sneller uit de hand dan bij simpele CRUD-applicaties; een aparte aanpak voor databaseoptimalisatie bij webshops gaat dieper in op die specifieke indexpatronen.
Hoe stem je de InnoDB buffer pool goed af?
De buffer pool bepaalt of jouw werkset in RAM past of steeds van schijf gehaald moet worden. Dat is een van de meest bepalende factoren in mysql performance tuning, en tegelijk een van de meest verkeerd begrepen.
Verhoog de grootte geleidelijk en kijk telkens wat er met de disk read trend gebeurt in plaats van blind een percentage toe te passen. Relevante velden uit SHOW ENGINE INNODB STATUS of Performance Schema:
Free buffersdat structureel op nul staat, wijst op een pool die te klein is voor de actuele belasting.Database pagesversusModified database pages(dirty pages) geeft aan hoeveel data nog naar schijf geschreven moet worden; een oplopend dirty page percentage kan later tot een schrijfpiek leiden.Pool readsdie blijven stijgen ondanks een grotere pool, betekent dat je werkset simpelweg groter is dan de pool, of dat queries onnodig veel data inlezen.
Statistiek om te onthouden: een hoge hitratio kan misleiden; monitor altijd de trend in disk reads en evictions naast de hitratio, niet in plaats daarvan.
Voor systemen met veel gelijktijdige verbindingen op een grote pool kan opsplitsing in meerdere buffer pool instances helpen, maar alleen bij bewezen mutex-contentie en met een minimale grootte per instance van ongeveer één gigabyte. Zonder die contentie voegt splitsen alleen complexiteit toe.
Welke serverconfiguratie en I/O-instellingen tellen het meest?
Configuratie komt pas nadat query’s en indexen op orde zijn. Een paar variabelen bepalen wel het verschil tussen een systeem dat soepel doorschrijft en een dat periodiek vastloopt:
innodb_flush_log_at_trx_commit: op 1 flush je bij elke transactie naar schijf, wat de veiligste optie is maar ook de traagste. Op 2 win je doorvoersnelheid tegen een klein risico op verlies van de laatste seconde transacties bij een crash.innodb_redo_log_capacity(ofinnodb_log_file_sizeop oudere versies) moet ruim genoeg zijn om je piekvolume op te vangen. Een richtlijn is voldoende capaciteit voor zestig tot negentig minuten piekbelasting, zodat write-stalls uitblijven.innodb_io_capacityeninnodb_io_capacity_maxhoren aan te sluiten op de werkelijke IOPS van je opslag. Onderschatting hiervan leidt tot achterblijvende flushing en een oplopend dirty page percentage.- Kies op Linux waar mogelijk
O_DIRECTals flush-methode om dubbele buffering tussen MySQL en de OS-cache te voorkomen.
Hoe rol je wijzigingen veilig uit en verifieer je het resultaat?
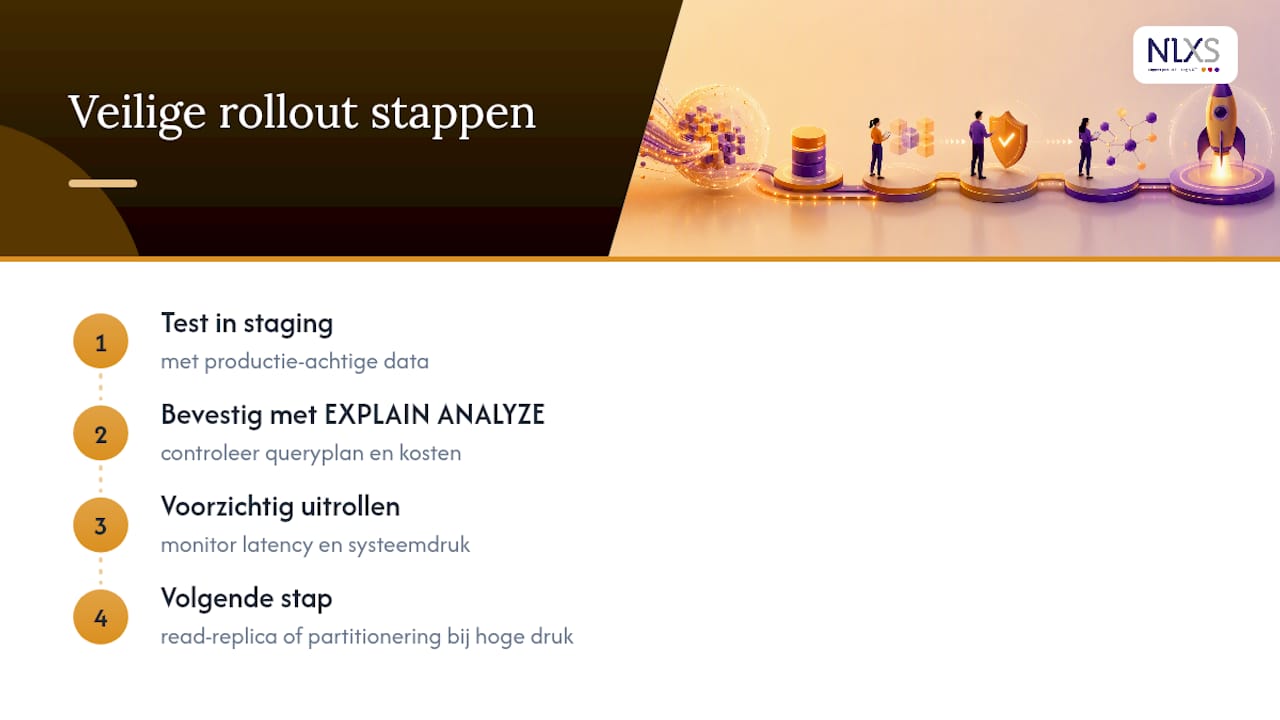
Test elke wijziging eerst in staging met productie-achtige data en bevestig met EXPLAIN ANALYZE. Rol daarna gecontroleerd uit en houd latency, Rows_examined en pages_evicted in de gaten. Blijft de druk hoog ondanks tuning? Dan is een read-replica of partitionering de volgende stap, niet nog een configuratieparameter.
Wanneer is uitbesteden slimmer dan zelf blijven tunen?
Heb je geen tijd of diepgaande MySQL-kennis in huis, en wil je 24/7 monitoring zonder zelf dienst te draaien? Managed services besparen dan vooral tijd en voorkomen kostbare downtime, met voorspelbare maandkosten in plaats van verrassingen achteraf.
— Ken
Beheerde hosting en databasesupport zonder gedoe
NLXS is het alternatief voor het zelf uitzoeken van elke buffer-pool-parameter en elke slow query op een zondagavond. Waar zelf tunen kennis, tijd en constante monitoring vergt, neemt NLXS die verantwoordelijkheid over met beheerde webhosting die is afgestemd op prestaties en beschikbaarheid, tegen een vast maandtarief zonder verrassingen achteraf.

Organisaties zoals universiteiten en lokale verenigingen laten hun infrastructuur vaak inrichten en bewaken door gespecialiseerde partijen, met snelle opvolging bij problemen binnen één dag. Twijfel je of jouw huidige serveromgeving en database nog wel bij je groei passen? Een gratis ICT-scan brengt in kaart waar de risico’s en besparingen zitten, zonder verplichtingen. Wil je eerst kennismaken voordat je overstapt? Dat kan via de kennismakingspagina van NLXS.
Bronnen
- InnoDB Buffer Pool Tuning: From Rule-of-Thumb to Real Signals
- MySQL 8.0 Reference Manual :: 10 Optimization
- MySQL Query Performance Tuning (2026): Practical Patterns for Faster SQL and Happier Servers
- From 100 TPS to 10,000 TPS: A Systematic Tuning Path for MySQL
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.