


IT responstijd betekenis: wat een leverancier je écht belooft
Responstijd in IT-dienstverlening is de tijd tussen jouw melding en het moment waarop de leverancier daadwerkelijk begint met het onderzoeken of oplossen van je probleem. Het is nadrukkelijk niet hetzelfde als oplostijd: de tijd die nodig is om het probleem daadwerkelijk uit de wereld te helpen. Wie deze twee door elkaar haalt, tekent een SLA die minder waard is dan hij lijkt.
Voor MKB’s en webshops die hosting of beheer uitbesteden, is dit onderscheid geen technisch detail maar een harde contractvoorwaarde. NLXS hanteert bijvoorbeeld een responstijdsgarantie van 24 uur: binnen die termijn krijg je een concrete eerste reactie op je melding, ongeacht wanneer die binnenkomt.
Kort samengevat komt het neer op dit:
- Responstijd = tijd tot eerste reactie op je melding.
- Oplostijd = tijd tot een werkende oplossing.
- Beide horen apart benoemd te worden in je SLA, met eigen meetmomenten.
Belangrijkste inzichten
Een afdwingbare responstijd in je SLA werkt alleen als hij is gekoppeld aan een oplostijd, een severity-matrix en toegang tot logs voor onderzoek.
| Punt | Details |
|---|---|
| Responstijd versus oplostijd | Responstijd is de tijd tot eerste reactie, oplostijd de tijd tot een werkende oplossing; beide horen apart in de SLA. |
| Incidentcategorieën vastleggen | Werk met P1 tot en met P4 zodat kritieke uitval altijd sneller wordt opgepakt dan cosmetische bugs. |
| NIS2 beïnvloedt SLA-afspraken | De meldplicht van 24 uur voor significante incidenten vraagt om even snelle reactieafspraken met je leverancier. |
| Logtoegang is geen bijzaak | Zonder contractuele toegang tot logs en back-ups is een snelle reactie weinig waard bij onderzoek. |
| NLXS als praktijkvoorbeeld | NLXS hanteert een harde 24-uurs responstijdsgarantie, zichtbaar toegepast bij klanten als TU Eindhoven en JCI Breda. |
Inhoudsopgave
- Wat is het verschil tussen responstijd en oplostijd?
- Waarom responstijd in de SLA vastleggen zo belangrijk is
- Checklist: wat hoort in elke SLA over responstijd?
- Wat doe je in de eerste minuten na een IT-incident?
- Hoe controleer je of je leverancier zich aan de responstijd houdt?
- Waarom NLXS 24 uur als harde grens hanteert
- Hoe NLXS je helpt bij het opstellen van sterke SLA-afspraken
- Bronnen
Wat is het verschil tussen responstijd en oplostijd?
De klok voor responstijd start op het moment dat een melding binnenkomt via ticket, e-mail of telefoon, afhankelijk van wat je SLA als geldig meldkanaal aanwijst. Oplostijd start pas zodra een technicus daadwerkelijk aan het probleem werkt, en eindigt wanneer de dienst weer normaal functioneert. Een goede SLA maakt dit onderscheid expliciet en koppelt er per incidentcategorie andere serviceniveaus aan.
Die categorieën, vaak aangeduid als P1 tot en met P4, bepalen hoe snel je een reactie mag verwachten:
- P1 (kritiek): je webshop of hoofdapplicatie ligt volledig plat, omzet loopt direct terug.
- P2 (hoog): een kernfunctie werkt niet, zoals het afrekenproces of e-mailverkeer.
- P3 (gemiddeld): hinderlijke fouten die het werk vertragen maar niet stilleggen.
- P4 (laag): cosmetische bugs of sporadische foutmeldingen zonder directe impact.
Pro-tip: Vraag je leverancier expliciet welke situaties onder P1 vallen. “Kritiek” wordt door leveranciers verrassend verschillend uitgelegd, en dat verschil bepaalt of je binnen 15 minuten of pas de volgende ochtend hulp krijgt.
Waarom responstijd in de SLA vastleggen zo belangrijk is
Een webshop die een uur plat ligt tijdens Black Friday verliest meer dan alleen omzet, ook klantvertrouwen loopt schade op. Zonder harde afspraken over responstijd hangt herstel af van de goodwill van je leverancier op dat moment, en dat is geen strategie waar je een bedrijf op bouwt.
Er is ook een juridische kant die de urgentie vergroot. Onder de NIS2-richtlijn moeten significante cyberincidenten binnen 24 uur worden gemeld bij de bevoegde autoriteit. Als jouw ICT-leverancier zelf pas na dagen reageert op een melding, kun jij die meldtermijn niet halen, met alle gevolgen van dien. De Rijksoverheid benadrukt dat verantwoordelijkheden tussen organisatie en leverancier daarom vooraf helder moeten zijn vastgelegd.
Concreet speelt een SLA drie rollen tegelijk:
- Het dwingt een leverancier tot meetbare, afdwingbare prestaties in plaats van vage beloften.
- Het regelt wie waarvoor aansprakelijk is als een responstijd wordt overschreden.
- Het geeft jou een instrument om binnen wettelijke meldtermijnen te kunnen blijven.
Checklist: wat hoort in elke SLA over responstijd?
Een responstijd van “binnen 24 uur” op papier betekent weinig zonder de bijbehorende details. Een model-SLA laat zien dat sterke afspraken altijd verder gaan dan één getal.
Neem deze punten mee in elke onderhandeling:
- Contactpunten en bereikbaarheid: wie neem je op werkdagen, ’s avonds en in het weekend, en via welk kanaal?
- Escalatiepaden: wat gebeurt er als de eerste contactpersoon niet reageert binnen de afgesproken tijd?
- Meetregels: wanneer start de klok precies, en via welk notificatiekanaal krijg jij bevestiging?
- Toegang tot logs en back-ups: kun jij of een onafhankelijke partij de gegevens inzien die nodig zijn voor onderzoek?
- Service credits: welke compensatie geldt als de leverancier de afgesproken responstijd mist?
- Rapportagefrequentie: hoe vaak ontvang je een overzicht van gemelde incidenten en behaalde tijden?
De volgorde waarin je dit vastlegt, maakt verschil:
- Bepaal eerst welke incidentcategorieën voor jouw organisatie kritiek zijn.
- Koppel daar per categorie een responstijd én een oplostijd aan.
- Leg vast wie toegang krijgt tot logs bij een ernstig incident.
- Spreek servicecredits af als sanctie op het niet nakomen van tijden.
In de praktijk missen veel MKB-contracten juist het punt over logtoegang, waardoor een leverancier binnen de afgesproken responstijd kan reageren zonder dat er daadwerkelijk onderzoek mogelijk is. Zorg dat je expliciete rechten op logs en back-ups opneemt, anders is die snelle “reactie” weinig meer dan een bevestigingsmail.
Pro-tip: Vraag jaarlijks om een gezamenlijke incidentoefening met je leverancier. Op papier lijkt elke SLA waterdicht, maar pas tijdens een geoefend scenario blijkt of escalatiepaden en contactgegevens ook echt kloppen.
Wat doe je in de eerste minuten na een IT-incident?
De eerste zestig minuten na een melding bepalen vaak hoeveel schade een incident uiteindelijk aanricht. Een helder draaiboek voorkomt paniekvoetbal.
- Meld en bevestig: noteer tijdstip, symptomen en betrokken systemen, en zorg voor een bevestiging van je leverancier.
- Verzamel eerste feiten: wie merkte het probleem op, welke systemen zijn geraakt, is er dataverlies zichtbaar?
- Bepaal isolatie en beslisautoriteit: wie mag beslissen om een systeem offline te halen, en op welk moment?
- Escaleer op tijd: schakel externe forensische hulp in zodra het incident de eigen expertise overstijgt.
- Communiceer gestructureerd: informeer interne stakeholders en, waar relevant, klanten via een vooraf afgesproken kanaal.
Een praktisch incident response plan beschrijft precies deze stappen: melding bevestigen, feiten vastleggen, isoleren waar nodig, het kernteam activeren en alles loggen voor een latere evaluatie.
Het verschil tussen een incident dat binnen een dag is opgelost en een incident dat weken nasleep heeft, zit zelden in de techniek. Het zit in de vraag of iedereen vooraf wist wie welk besluit mocht nemen.
Hoe controleer je of je leverancier zich aan de responstijd houdt?
Beloftes op papier zijn pas waardevol als je ze kunt controleren. Zorg dat drie tijdstippen altijd zichtbaar zijn: het moment van ticketaanmaak, het moment van acceptatie door de leverancier, en het moment van de eerste inhoudelijke update.
Vraag periodiek om een overzicht met deze punten:
- Totaal aantal gemelde incidenten per kwartaal, uitgesplitst per categorie.
- Gemiddelde responstijd per categorie, afgezet tegen de afgesproken norm.
- Openstaande of terugkerende issues die nog niet structureel zijn opgelost.
- Toegepaste servicecredits, inclusief de reden waarom een norm niet werd gehaald.
Documenteer afwijkingen altijd met tijdstempels en schermafbeeldingen van tickets. Zonder dat papierspoor is een geschil over gemiste servicecredits vrijwel niet te winnen.
Waarom NLXS 24 uur als harde grens hanteert
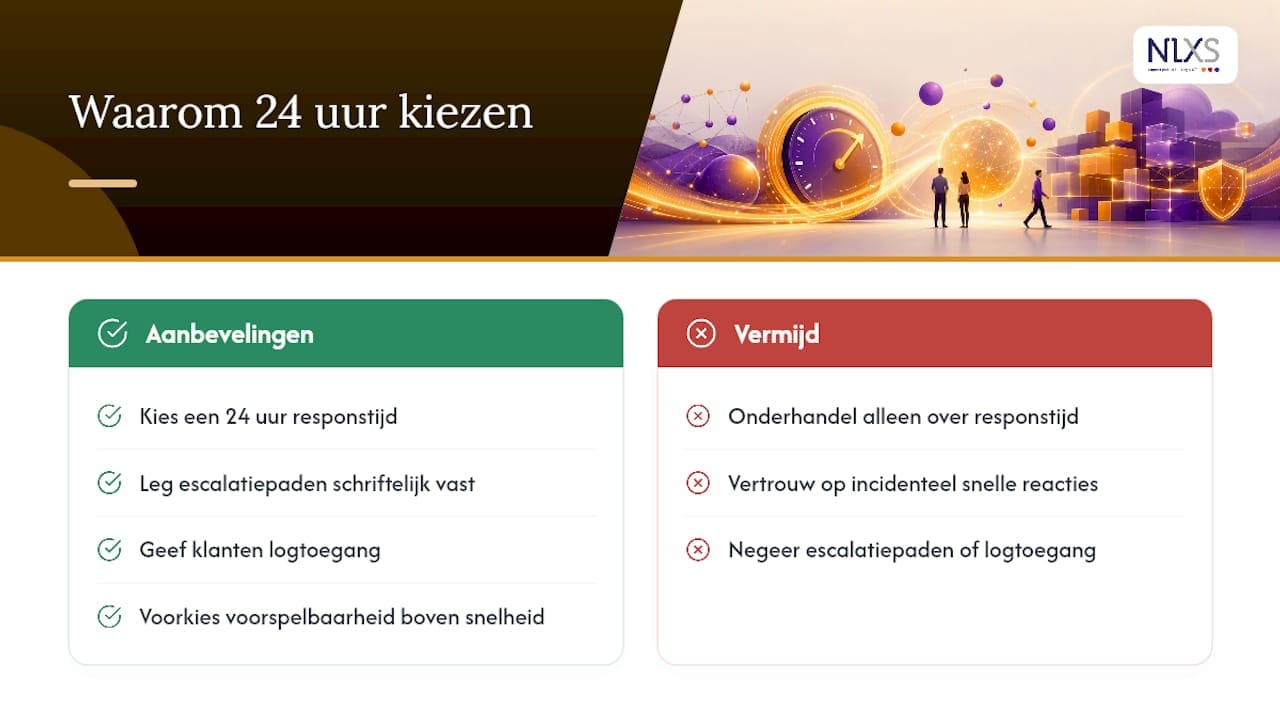
Wij kiezen bewust voor een responstijd van 24 uur, niet omdat het technisch het maximaal haalbare is, maar omdat het een belofte is die we onder alle omstandigheden waarmaken. Klanten zoals TU Eindhoven en JCI Breda draaien op infrastructuur waar uitval direct impact heeft op onderwijs of bedrijfsvoering, en daar telt een reactie die je kunt plannen zwaarder dan een reactie die soms sneller is en soms uitblijft.
Wat ik in de praktijk vaak zie: organisaties onderhandelen fel over de responstijd zelf, maar vergeten escalatiepaden en logtoegang vast te leggen. Dat is de plek waar SLA’s echt hun waarde bewijzen of verliezen.
— Ken
Hoe NLXS je helpt bij het opstellen van sterke SLA-afspraken
NLXS is de partner die je haalt uit de situatie waarin je zelf moet uitzoeken of een responstijd van “zo snel mogelijk” genoeg is. Waar veel leveranciers vaag blijven over reactietermijnen, werkt NLXS met een concrete 24-uurs responstijdsgarantie die je gewoon in je contract terugziet, niet als marketingtekst maar als afdwingbare afspraak.

Twijfel je of je huidige SLA voldoende dekking biedt, of ben je nog op zoek naar een leverancier die dit wel goed regelt? Begin met een gratis ICT-scan, waarin we samen kijken naar je huidige risico’s, je incidentprocessen en of je responstijden aansluiten bij wat je organisatie nodig heeft. Voor de hosting zelf kun je direct kijken naar onze webhosting-oplossingen, waar de responstijdsgarantie standaard onderdeel van is.
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.