


Automatische hosting schaalbaarheid instellen: praktische gids
De meest betrouwbare aanpak voor het instellen van automatische hosting-schaalbaarheid combineert horizontale autoscaling met health checks, een load balancer en een schedule- of voorspellingslaag. Begin met minimale schaalregels op een managed platform zoals Azure AKS of Google GKE, voer een loadtest uit en ga pas naar productie als je metrics kloppen. NLXS helpt Nederlandse en Centraal-Europese IT-teams bij elke stap van deze implementatie.
Drie directe actiepunten om mee te starten:
- Stel een minimaal en maximaal aantal instanties in zodat je nooit onbedoeld te ver schaalt of juist kapaciteit tekortkomt.
- Configureer health checks en alerts op CPU, latency en foutpercentage voordat je autoscaling activeert.
- Voer een korte loadtest uit (ramp-up, sudden stress) om te verifiëren dat je schaalregels daadwerkelijk triggeren op de juiste drempelwaarden.
Inhoudsopgave
- Wat is automatisch schalen en waarom is het essentieel?
- Welke typen schaalbaarheid en componenten moet je kennen?
- Wanneer moet je schalen: welke metrics en triggers gebruik je?
- Hoe implementeer je autoscaling in een Centraal-Europese omgeving?
- Hoe ga je om met extreme pieken die autoscaling niet bijhoudt?
- Monitoring, load testing en kosten: wat moet je meten en bewaken?
- Stap-voor-stap checklist om autoscaling live te zetten
- Wanneer is automatische schaalbaarheid écht noodzakelijk?
- Veelgemaakte fouten en best practices bij automatische schaalbaarheid
- Belangrijkste inzichten
- Waarom een pragmatische aanpak bij autoscaling loont
- NLXS helpt je verder met managed hosting en schaalbaarheid
- Aanbevolen bronnen voor verdieping
Wat is automatisch schalen en waarom is het essentieel?
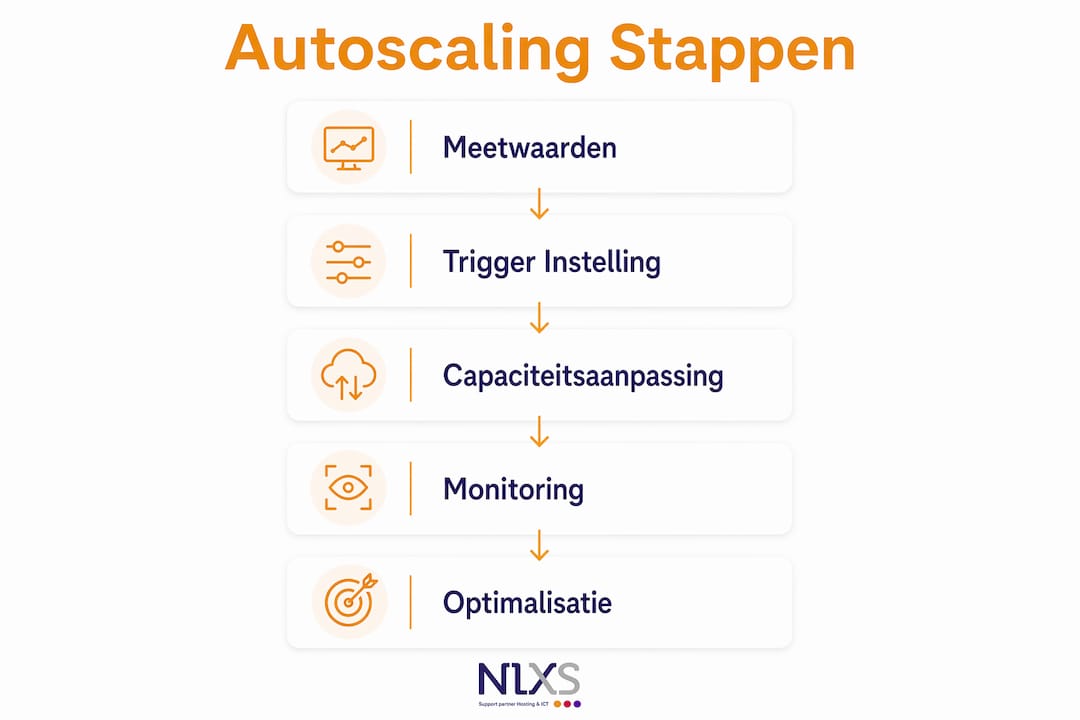
Automatisch schalen, in de industrie aangeduid als autoscaling, voegt compute-instanties of applicatiepods toe wanneer de vraag stijgt en verwijdert ze weer zodra het rustig wordt. Het systeem reageert op meetwaarden zoals CPU-gebruik, geheugendruk of het aantal binnenkomende verzoeken, zonder dat een beheerder handmatig hoeft in te grijpen.
De drie kernvoordelen zijn concreet. Ten eerste blijft de prestatie stabiel tijdens pieken omdat extra capaciteit automatisch beschikbaar komt. Ten tweede dalen de kosten buiten piekuren doordat ongebruikte instanties worden afgeschaald. Ten derde verbetert de weerbaarheid: een gezonde instantie neemt het werk over van een falende zonder menselijke tussenkomst.
Azure Monitor en Google Cloud bieden beide native autoscaling-functies die je kunt koppelen aan schedule-based regels voor voorspelbare pieken én aan reactieve regels voor onverwachte belasting. De combinatie van beide is wat de aanpak echt betrouwbaar maakt.
Pro-tip: Stel altijd een minimum van minstens twee instanties in, ook in rustige perioden. Eén instantie is een single point of failure, en de opstarttijd van een nieuwe instantie is te lang om als vangnet te dienen bij een plotselinge piek.
Welke typen schaalbaarheid en componenten moet je kennen?
Horizontaal versus verticaal schalen
Horizontaal schalen (scale out/in) voegt instanties toe of verwijdert ze. Verticaal schalen (scale up/down) vergroot of verkleint de resources van een bestaande instantie, zoals meer CPU of geheugen. In cloud-native omgevingen heeft horizontaal schalen de voorkeur: het is fijnmaziger, goedkoper te automatiseren en vereist geen herstart van de applicatie.
Verticaal schalen is zinvol voor databases of legacy-applicaties die niet eenvoudig te distribueren zijn. Voor de meeste webapplicaties en API’s is horizontaal schalen de standaard.
Kerncomponenten van een schaalbare architectuur
Een werkende autoscaling-setup bestaat uit de volgende onderdelen:
- Load balancer: verdeelt inkomend verkeer over beschikbare instanties en detecteert ongezonde nodes via health checks.
- Autoscalinggroep of pod-autoscaler: beheert het aantal actieve instanties op basis van gedefinieerde regels. In Kubernetes zijn dit de Horizontal Pod Autoscaler (HPA) en de Vertical Pod Autoscaler (VPA).
- Cluster Autoscaler: schaalt het aantal nodes in een Kubernetes-cluster op of af wanneer pods niet kunnen worden ingepland.
- Persistente opslag en databases: schalen apart van de applicatielaag. Gebruik replicatie en sharding voor databases; koppel opslag los van de applicatiecontainer.
- Health checks: liveness- en readiness-probes bepalen of een instantie verkeer mag ontvangen.
| Component | Functie | Aandachtspunt |
|---|---|---|
| Load balancer | Verkeersverdeling en health detection | Configureer timeouts en retry-limieten |
| HPA (Kubernetes) | Schaalt pods op basis van CPU/custom metrics | Vereist metrics-server in het cluster |
| VPA (Kubernetes) | Past resource-requests aan per pod | Niet combineren met HPA op dezelfde metric |
| Cluster Autoscaler | Schaalt nodes in/uit | Stel min/max nodes in per nodepool |
| Persistente opslag | Stateful data buiten de pod | Gebruik managed storage (bijv. Azure Disk, GCP Persistent Disk) |
Google Cloud Well-Architected adviseert uitdrukkelijk om componenten onafhankelijk te schalen en services stateless te ontwerpen. Stateless services slaan geen sessiedata lokaal op, waardoor elke instantie elk verzoek kan afhandelen. Vermijd sticky sessions; gebruik in plaats daarvan een gedeelde cache zoals Redis voor sessiebeheer.
Wanneer moet je schalen: welke metrics en triggers gebruik je?
De keuze van de juiste meetwaarden bepaalt of autoscaling soepel werkt of juist problemen veroorzaakt. Gebruik te gevoelige drempelwaarden en je krijgt oscillatie: instanties die voortdurend op- en afschalen. Stel ze te ruim in, dan reageert het systeem te laat.
| Metric | Aanbevolen drempelwaarde | Wanneer te gebruiken |
|---|---|---|
| CPU-gebruik | een geschikte gemiddelde drempelwaarde over enkele minuten | Compute-intensieve workloads |
| Geheugengebruik | passende drempelwaarde | Memory-bound applicaties |
| Latency | Boven SLA-grens | API’s en interactieve applicaties |
| Request queue length | gedurende een relevante tijdspanne boven nul | Asynchrone verwerking |
| Foutpercentage | boven een klein percentage over korte tijd | Vroege waarschuwing voor overbelasting |
| Custom metric (bijv. orders/minuut) | Afhankelijk van capaciteitsmodel | E-commerce en transactionele systemen |
Naast reactieve metrics zijn zakelijke triggers minstens zo belangrijk. Een marketingcampagne, productlancering of seizoenspiek is voorspelbaar. Azure raadt aan om schedule-based scaling te combineren met reactieve regels: plan extra capaciteit in vóór een bekende piek en laat reactieve autoscaling de onverwachte uitschieters opvangen.
Houd er rekening mee dat autoscaling niet onmiddellijk reageert. Aggregatieperioden en opstarttijden betekenen dat schaaloperaties minuten kunnen duren, soms langer bij VM Scale Sets dan bij containerized workloads. Plan daar ruimte voor in je drempelwaarden.
Pro-tip: Gebruik historische verkeersdata om een basispatroon te bouwen. Zelfs een eenvoudige weekkalender met hogere minimumcapaciteit op maandagochtend of vrijdagmiddag voorkomt trage opstarttijden op de drukste momenten.
Hoe implementeer je autoscaling in een Centraal-Europese omgeving?
Er zijn vier concrete implementatieroutes, elk met eigen voor- en nadelen.
Cloud VM autoscaling (VM Scale Sets / Managed Instance Groups)
Geschikt voor lift-and-shift applicaties die nog niet gecontaineriseerd zijn. Je definieert een instance template en een schaalbeleid op basis van CPU of een custom metric. Het nadeel: provisioning van een nieuwe VM duurt doorgaans 2–5 minuten, wat te lang is voor plotselinge pieken.
Kubernetes: HPA, VPA en Cluster Autoscaler
De meest flexibele aanpak voor moderne applicaties. HPA schaalt het aantal pods op basis van CPU, geheugen of externe metrics (via de custom metrics API). VPA past de resource-requests van bestaande pods aan, wat nuttig is als je workload-grootte varieert maar niet eenvoudig horizontaal schaalt. De Cluster Autoscaler voegt nodes toe wanneer pods niet ingepland kunnen worden.
GKE Autopilot en Azure AKS bieden beheerde Kubernetes-modi waarbij nodes en resources automatisch worden beheerd. Dit verlaagt de operationele last aanzienlijk, wat voor kleinere IT-teams een concreet voordeel is.
Serverless en managed platformen
Serverless functies (Azure Functions, Google Cloud Run) schalen naar nul buiten piekuren en starten direct bij een verzoek. De beperkingen zijn cold starts (vertraging bij de eerste aanroep na een rustperiode) en maximale uitvoeringstijd per functie. Voor korte, stateless taken is dit de meest kosteneffectieve optie.
Regionale overwegingen voor Centraal Europa
Kies regio’s met lage netwerklatency voor je gebruikers. Voor Nederlandse en Belgische gebruikers zijn West-Europa (Amsterdam) en Noord-Europa (Dublin/Frankfurt) logische keuzes. Controleer ook data residency-vereisten: de AVG vereist dat persoonsgegevens binnen de EER blijven, tenzij er aanvullende waarborgen zijn. Netwerkpeering tussen regio’s beïnvloedt latency bij gedistribueerde setups.
| Implementatieoptie | Opstarttijd | Beheerlast | Geschikt voor |
|---|---|---|---|
| VM Scale Sets | enkele minuten | Hoog | Lift-and-shift, legacy apps |
| Kubernetes HPA/VPA | ongeveer een halve tot paar minuten | Middel | Containerized microservices |
| GKE Autopilot / AKS | korte opstarttijd | Laag | Teams zonder Kubernetes-expertise |
| Serverless (Cloud Run) | zeer korte opstarttijd | Zeer laag | Stateless functies, event-driven |
Pro-tip: Gebruik voor Centraal-Europese deployments altijd een regionale load balancer met anycast-IP. Dit verlaagt de latency voor gebruikers in meerdere landen zonder dat je meerdere aparte deployments hoeft te beheren.
Hoe ga je om met extreme pieken die autoscaling niet bijhoudt?
Autoscaling is geen oplossing voor een stampede: een plotselinge golf van duizenden gelijktijdige verzoeken binnen enkele seconden. De opstarttijd van nieuwe instanties is simpelweg te lang om dit op te vangen.
Pro-tip: Test altijd een “sudden stress”-scenario in je loadtest: simuleer een vertienvoudiging van het verkeer in 10 seconden. Als je applicatie dan fouten geeft, heb je een aanvullende maatregel nodig naast autoscaling.
Aanvullende technieken die je combineert met autoscaling:
- Virtuele wachtrij: bij extreme pieken zoals ticketverkoop of productdrops is een virtuele wachtrij effectiever dan autoscaling alleen. Bezoekers wachten geordend in een rij terwijl de applicatie alleen ontvangt wat ze veilig aankan.
- Rate limiting: beperk het aantal verzoeken per IP of gebruiker per tijdseenheid. Implementeer dit op de load balancer of via een API-gateway.
- Edge caching via CDN: statische assets en zelfs dynamische pagina’s met korte TTL’s serveer je via een CDN (Cloudflare, Azure CDN). Dit verlaagt de belasting op je origin-servers drastisch.
- Request throttling en progressive degradation: bij overbelasting geef je minder kritieke functies op (bijv. aanbevelingen of reviews) terwijl de kernfunctionaliteit beschikbaar blijft.
- Pre-warming: plan extra instanties in vóór een bekende piek via schedule-based scaling, zodat de capaciteit al beschikbaar is voordat het verkeer arriveert.
Combineer deze technieken met voorspellende schaalregels voor de beste bescherming. Meer praktische aanpakken voor piekverkeer bij webshops vind je in de NLXS-gids specifiek voor e-commerce.
Monitoring, load testing en kosten: wat moet je meten en bewaken?
Observability-stack opzetten
Activeer autoscaling nooit zonder een werkende observability-stack. De minimale set:
- Metrics: Cloud Monitoring (GCP), Azure Monitor of een zelfbeheerde Prometheus-stack met Grafana voor visualisatie.
- Distributed tracing: gebruik OpenTelemetry om verzoeken door meerdere services te volgen. Dit maakt het zichtbaar waar latency ontstaat bij hoge belasting.
- Logging: centraliseer logs in een platform zoals Loki, Azure Log Analytics of Google Cloud Logging. Stel alerts in op foutpatronen.
- Alerting: configureer drempelwaarden voor CPU, latency en foutpercentage met een escalatiepad naar de dienstdoende beheerder.
Load testing uitvoeren
Voer drie testscenario’s uit voordat je naar productie gaat:
- Ramp-up test: verhoog het verkeer geleidelijk over 10–15 minuten om te zien bij welke belasting autoscaling triggert.
- Sudden stress test: simuleer een plotselinge piek om opstarttijden en foutpercentages te meten.
- Soak test: houd een constante hoge belasting aan gedurende 30–60 minuten om geheugenlekkages en langzame degradatie te detecteren.
Geschikte tools zijn Apache JMeter (uitgebreid, Java-gebaseerd), k6 (scriptbaar, developer-friendly) en Locust (Python, goed voor gedistribueerde tests). Instrumenteer metrics en logs voordat je een test uitvoert, anders mis je de data die je nodig hebt om schaaldrempels te valideren.
Kostenbeheersing
- Stel altijd een maximum aantal instanties in om onverwachte kosten te voorkomen.
- Gebruik scale-to-zero voor niet-kritieke omgevingen (staging, test).
- Combineer schedule-based scaling met reactieve regels: dit voorkomt dat je betaalt voor capaciteit die je niet nodig hebt.
- Voer maandelijks een FinOps-review uit: vergelijk werkelijk gebruik met de ingestelde limieten en pas drempelwaarden aan.
Stap-voor-stap checklist om autoscaling live te zetten
- Definieer SLA en KPI’s: bepaal de maximale latency, beschikbaarheidsdoelstelling (bijv. 99,9%) en het maximale foutpercentage dat acceptabel is.
- Kies je schaalstrategie: horizontaal voor stateless services, verticaal alleen voor databases of legacy-componenten.
- Maak services stateless: verplaats sessiedata naar een gedeelde cache (Redis) en sla geen lokale bestanden op in applicatiecontainers.
- Configureer load balancer en health checks: stel liveness- en readiness-probes in met realistische timeouts.
- Stel min/max instanties in: begin conservatief (bijv. min 2, max 10) en pas aan na de eerste productieweek.
- Definieer schaalregels: combineer reactieve metrics (CPU 65%) met schedule-based regels voor bekende pieken.
- Codeer infrastructuur als code: gebruik Terraform of ARM-templates zodat schaalregels versiebeheerd zijn en reproduceerbaar.
- Voer loadtests uit: ramp-up, sudden stress en soak test in een staging-omgeving die productie nabootst.
- Integreer in CI/CD: deploy schaalregels automatisch via je pijplijn (GitHub Actions, Azure DevOps). Voeg een rollback-procedure toe voor het geval een nieuwe configuratie problemen veroorzaakt.
- Cutover en nazorg: ga live, monitor de eerste 48 uur intensief en stel een wekelijkse tuning-cyclus in voor de eerste maand.
Pro-tip: Documenteer je schaalregels in een runbook met de redenering achter elke drempelwaarde. Zonder context past een nieuwe collega de waarden aan zonder te begrijpen waarom ze zo zijn ingesteld, wat tot oscillatie of ondercapaciteit leidt.
Wanneer is automatische schaalbaarheid écht noodzakelijk?
Niet elke website heeft autoscaling nodig. Maar voor de volgende situaties is het geen luxe, het is een vereiste.
E-commerce en webshops: een WooCommerce-webshop met een Black Friday-sale kan in minuten van 50 naar 5.000 gelijktijdige bezoekers gaan. Autoscaling gecombineerd met een CDN en een wachtrij voor het afrekenproces voorkomt dat de checkout crasht op het moment dat conversie het hoogst is. Meer over schaalbaarheidsopties voor groeiende webshops lees je in de NLXS-gids voor e-commerce hosting.
Ticketverkoop en productlanceringen: dit zijn de klassieke stampede-scenario’s. Duizenden gebruikers proberen tegelijkertijd een actie te voltooien.
Autoscaling reageert te traag op een plotselinge stampede. Een virtuele wachtrij reguleert het inkomende verkeer bij de ingang, zodat je applicatie alleen ontvangt wat ze veilig aankan. Dat geeft je schaalstrategie de ruimte om te werken in plaats van dat je de applicatie vraagt om in één keer een stortvloed te absorberen.
Membership- en e-learningplatformen: bij een live webinar of de release van een nieuwe cursus logt een groot deel van de leden gelijktijdig in. Schaal de stateless frontend horizontaal en zorg dat de database voldoende leescapaciteit heeft via read replicas. Sessiemanagement via Redis voorkomt dat gebruikers uitgelogd worden bij een scale-out.
Veelgemaakte fouten en best practices bij automatische schaalbaarheid
Fouten die je wilt vermijden
- Geen maximum instellen: zonder bovengrens kan een bug of DDoS-aanval onbeperkt instanties spawnen en een enorme rekening veroorzaken.
- Stateful services niet herontwerpen: een applicatie die sessiedata lokaal opslaat, werkt niet correct achter een load balancer met meerdere instanties.
- Geen loadtest uitvoeren: schaalregels die nooit getest zijn, triggeren mogelijk niet op het juiste moment of veroorzaken oscillatie.
- Te strakke thresholds: een CPU-drempel van 50% met een aggregatieperiode van 1 minuut leidt tot voortdurend op- en afschalen, wat zelf latency introduceert.
- Regiokeuze negeren: een deployment in een regio ver van je gebruikers verhoogt de latency structureel, ongeacht hoeveel instanties je toevoegt.
Best practices
- Ontwerp services stateless en gebruik circuit breakers (bijv. via Istio of een API-gateway) om cascadefouten te voorkomen.
- Combineer predictive en reactive schaalregels voor maximale dekking.
- Integreer DDoS-bescherming (Azure DDoS Protection, Google Cloud Armor) als onderdeel van je schaalarchitectuur, niet als nagedachte.
- Beperk toegang tot autoscaling-API’s via strikte IAM-rollen: alleen geautoriseerde CI/CD-systemen en beheerders mogen schaalregels aanpassen.
- Documenteer elke schaalregel in een runbook en koppel alerts aan een escalatiepad.
Belangrijkste inzichten
Automatische hosting-schaalbaarheid werkt het best als je horizontale autoscaling combineert met stateless services, health checks en een schedule-laag voor voorspelbare pieken, aangevuld met een virtuele wachtrij voor stampedes.
| Punt | Details |
|---|---|
| Horizontaal schalen als standaard | Voeg instanties toe in plaats van te upgraden; vereist stateless services en een gedeelde cache. |
| Combineer reactief en schedule-based | Reactieve regels vangen onverwachte pieken op; schedule-regels dekken bekende drukke momenten. |
| Autoscaling is niet onmiddellijk | Opstarttijden variëren van seconden (serverless) tot minuten (VM Scale Sets); plan drempelwaarden daarop. |
| Loadtest vóór productie | Voer ramp-up, sudden stress en soak tests uit om schaalregels te valideren voordat je live gaat. |
| NLXS voor managed implementatie | NLXS biedt managed hosting, ICT-scans en implementatieondersteuning voor teams die autoscaling willen uitrollen zonder eigen schaalteam. |
Waarom een pragmatische aanpak bij autoscaling loont
Er is een hardnekkig misverstand in de markt: dat autoscaling een set-and-forget oplossing is. Je configureert het eenmalig, en daarna regelt het zichzelf. Dat klopt niet.
Autoscaling is een levend systeem. Verkeerspatronen veranderen, applicaties groeien, en drempelwaarden die vorig kwartaal werkten, zijn nu te ruim of te krap. Teams die dit begrijpen, plannen een maandelijkse tuning-cyclus in en behandelen schaalregels als code: versiebeheerd, getest en gedocumenteerd.
Wat ik ook zie bij Nederlandse bedrijven: de neiging om te beginnen met de meest complexe oplossing. Een volledig Kubernetes-cluster met HPA, VPA en Cluster Autoscaler is indrukwekkend, maar voor een WooCommerce-webshop met 10.000 bezoekers per dag is een managed platform met autoscaling vaak meer dan voldoende en aanzienlijk eenvoudiger te beheren. Begin klein, meet wat er werkelijk gebeurt, en schaal de complexiteit op als de situatie dat vraagt.
De combinatie van een goede observability-stack, een getest loadtest-scenario en een heldere runbook is wat het verschil maakt tussen autoscaling dat werkt en autoscaling dat je om 3 uur ’s nachts wakker maakt.
NLXS helpt je verder met managed hosting en schaalbaarheid
Autoscaling opzetten kost tijd die je als IT-beheerder of ontwikkelaar niet altijd hebt. NLXS neemt de technische uitvoering uit handen: van het configureren van schaalregels en het integreren van monitoring tot het uitvoeren van loadtests en het inrichten van CI/CD-koppelingen. Klanten zoals TU Eindhoven en JCI Breda profiteren van betrouwbare infrastructuuroplossingen met snelle responstijden, zonder verrassingen in de rekening.

Het concrete voordeel: je hoeft geen eigen schaalteam op te zetten. NLXS levert implementatieondersteuning, 24/7 monitoring en een transparante prijsstructuur, afgestemd op de behoeften van Nederlandse en Centraal-Europese bedrijven. Of je nu een webshop wilt beschermen tegen piekverkeer of een membership-platform wilt laten groeien zonder downtime, NLXS denkt mee vanaf de eerste stap.
Start met een gratis ICT-scan om je huidige hostingomgeving te beoordelen, of bekijk de managed hosting-opties als startpunt voor een gesprek.
Aanbevolen bronnen voor verdieping
Raadpleeg ten minste drie van deze bronnen voordat je productiewijzigingen doorvoert. De officiële cloud-documentatie bevat configuratievoorbeelden die je direct kunt toepassen.
- Azure Autoscaling Best Practices (Microsoft Learn): uitgebreide richtlijnen voor het combineren van schedule-based en reactieve schaalregels in Azure-omgevingen.
- Azure Well-Architected: Scaling: uitleg over aggregatieperioden, opstarttijden en betrouwbaarheidsoverwegingen bij autoscaling.
- Google Cloud Architecture Framework: Elasticity: principes voor onafhankelijke componentscaling, stateless ontwerp en GKE Autopilot.
- Queue-Fair: Website schaalbaarheid voor groot verkeer: praktische uitleg over virtuele wachtrijen als aanvulling op autoscaling bij stampedes.
- Horizontaal vs. verticaal schalen (Queue-Fair): vergelijking van beide schaalstrategieën met praktische aanbevelingen.
- Wat maakt een cloudoplossing schaalbaar? (Top Wereld): overzicht van kerncomponenten en testaanpak voor schaalbare cloudarchitecturen.
- NLXS: wanneer managed hosting nodig is: praktische leidraad voor het beoordelen of uitbesteding van hosting de juiste keuze is voor jouw situatie.
| Bron | Onderwerp | Wanneer te raadplegen |
|---|---|---|
| Microsoft Learn (Autoscaling) | Azure-schaalregels en schedule-based scaling | Bij implementatie op Azure |
| Google Cloud Architecture Framework | Stateless ontwerp en GKE Autopilot | Bij Kubernetes of GCP-deployments |
| Queue-Fair (schaalbaarheid) | Virtuele wachtrijen en stampede-aanpak | Bij ticketverkoop of productlanceringen |
| Top Wereld (cloudschaalbaarheid) | Componentoverzicht en testaanpak | Bij architectuurontwerp en loadtesting |
| NLXS managed hosting | Uitbesteding en implementatieondersteuning | Bij behoefte aan managed oplossing |
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.