


VoIP jitter oplossen: praktisch stappenplan voor IT-beheerders
Meet eerst met gelijktijdige Wireshark-captures en isoleer de RTP-stroom, want gokken naar de oorzaak kost meer tijd dan meten. Zoek daarna naar congestie, verkeerde QoS-mapping of een uplink-bottleneck in het netwerk en los die oorzaak op. Vergroot de jitterbuffer alleen als tijdelijke lapmiddel, want elke millisecond extra buffer verhoogt de ervaren vertraging tijdens het gesprek.
Kort samengevat:
- Meet de jitter op drie punten tegelijk: op het endpoint, de switch en de uplink, omdat één meting zelden het probleem aantoont.
- Bij een jitter onder 30 ms en verlies onder 1% op bekabelde netwerken is de kwaliteit doorgaans acceptabel, hogere waarden wijzen op problemen.
- Gebruik Wireshark voor gelijktijdige captures op meerdere punten en analyseer de RTP-streams om jitter, verlies en de oorzaak van vertragingen te ontdekken.
- Een grote jitterbuffer vertraagt het gesprek op zich, maar lost onderliggende netwerkproblemen niet op en mag slechts tijdelijk worden gebruikt.
- Controleer de sequentienummers tussen eindpunt- en netwerkcaptures om vast te stellen of het verlies of de vertraging in je eigen netwerk of bij de provider ontstaat.
Inhoudsopgave
- Wat is jitter (IPDV) en welke normen gelden?
- Hoe je jitter meet: meetpunten, tools en praktische drempels
- Reproduceerbare diagnoseprocedure met Wireshark en RTP-analyse
- Concrete oplossingen: QoS, wachtrijen, uplink en jitterbufferbeleid
- Verifiëren en monitoren: RTCP/XR, continue tests en alerts
- Praktische checklist en ervaring: hoe NLXS VoIP-jitter structureel voorkomt
- Auteursperspectief: prioriteiten en veelgemaakte fouten
- Aanbod: NLXS’ VoIP- en netwerkdienst als structurele oplossing
- Veelgestelde vragen
- Bronnen
Wat is jitter (IPDV) en welke normen gelden?
Jitter, technisch IP packet delay variation (IPDV) genoemd, is de variatie in aankomsttijd tussen opeenvolgende pakketten die hetzelfde spraaksignaal vervoeren. Dat is iets anders dan latency, de totale reistijd van een pakket, en anders dan packet loss, het aantal pakketten dat helemaal niet aankomt. RIPE beschrijft IPDV als de variatie in vertraging van unidirectionele, opeenvolgende pakketten, en dat onderscheid is belangrijk: voor spraak telt vooral de eenrichtingsvariatie, omdat je telefoon elk pakket op het juiste moment moet afspelen.
Voor VoIP is dit kritisch omdat spraak in real time wordt opgebouwd uit kleine pakketjes. Komt een pakket te vroeg of te laat, dan moet de jitterbuffer dat verschil opvangen voordat het hoorbaar wordt. ITU-T G.114 geeft planningsrichtlijnen voor one-way delay en beschrijft hoe een de-jitterbuffer gemiddeld ongeveer de helft van zijn piekvertraging aan de gemiddelde vertraging toevoegt. Dat betekent dat een grotere buffer de variatie maskeert, maar de totale vertraging laat oplopen.
Een laatste punt dat vaak over het hoofd wordt gezien: resultaten zijn alleen vergelijkbaar als meetpunt, richting en interval steeds identiek zijn. Verschuif je het meetpunt van endpoint naar switch, dan verschuift ook het getal, ook al is er niets veranderd aan de werkelijke netwerkkwaliteit.
Hoe je jitter meet: meetpunten, tools en praktische drempels
De locatie van je meting bepaalt wat je ziet. Meet bij voorkeur op drie punten tegelijk: het endpoint (de telefoon of softphone zelf), de toegangsswitch waar het toestel op aangesloten is, en de router of uplink naar de operator. Gelijktijdige captures op meerdere punten zijn onmisbaar, want een enkele meting bewijst zelden waar in het pad het probleem ontstaat.
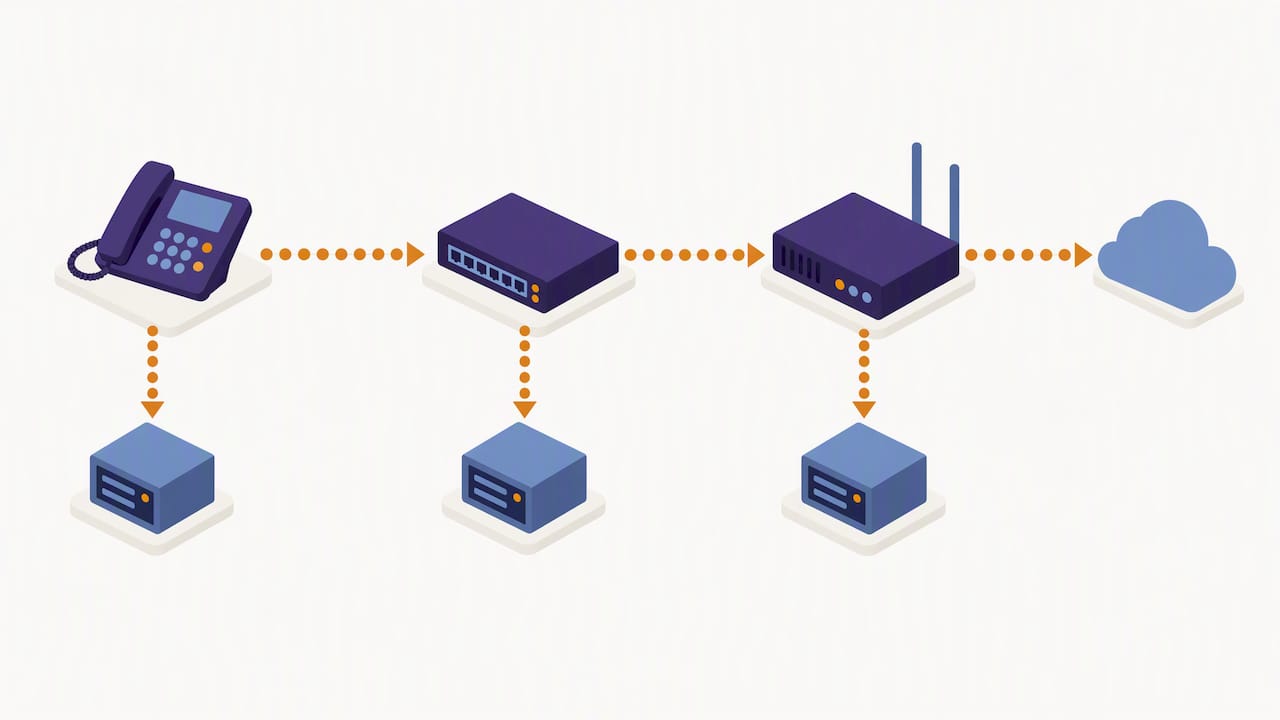
In Wireshark zet je dit op met een SPAN-capture op de switch, gecombineerd met een lokale capture op het endpoint zelf. Open vervolgens Telefonie > RTP > RTP Stream Analysis om per gesprek jitter, verlies en deltatijd te zien, en gebruik de RTP Player om het gesprek daadwerkelijk te beluisteren. Cisco’s documentatie over Wireshark-analyse beschrijft deze workflow stap voor stap: gesprek identificeren, capture starten, RTP Stream Analysis openen en de audio beluisteren om klachten te koppelen aan meetwaarden.
Noteer bij elke capture:
- Het exacte tijdstip en de call-ID van het gesprek.
- Het bron- en doel-IP-adres van de RTP-stroom.
- De gemeten jitterwaarde en het verliespercentage per richting.
Voor praktische drempels geldt dat Cisco’s troubleshooting-richtlijn voor Catalyst-switches jitter onder 30 ms als werkbare grens hanteert en pakketverlies boven 1% als signaal om verder te onderzoeken. Op draadloze verbindingen ligt de praktische tolerantie meestal lager, omdat radio-interferentie en roaming extra variatie toevoegen bovenop wat de bekabelde uplink al oplevert.
Bewaar elke capture met een duidelijke naam die tijdstip, call-ID en locatie bevat, zodat je collega’s in het netwerkteam de data zonder extra uitleg kunnen herleiden naar het gesprek waarover een gebruiker klaagde.
Reproduceerbare diagnoseprocedure met Wireshark en RTP-analyse
Een klacht als “het gesprek hapert” is pas bruikbaar als je die kunt herleiden naar een meetbaar patroon. De volgende procedure maakt dat herhaalbaar:
- Noteer tijdstempel, call-ID en het telefoonnummer of de extensie van de klacht.
- Start gelijktijdige captures op endpoint en switch of router, zodat je dezelfde pakketten vanuit twee perspectieven vastlegt.
- Reproduceer het probleem, idealiter tijdens een belasting die vergelijkbaar is met het moment van de klacht.
- Stop beide captures en archiveer ze direct onder dezelfde bestandsnaam met tijdstip en call-ID.
- Open de capture in Wireshark en ga naar RTP Stream Analysis om jitter, deltatijd en verlies per stroom te bekijken.
- Beluister het gesprek via de RTP Player om te verifiëren of het meetpatroon overeenkomt met wat de gebruiker daadwerkelijk hoorde.
Zodra je de RTP-stream geïsoleerd hebt, vergelijk je de sequentienummers tussen de endpoint-capture en de netwerkcapture. Cisco laat zien hoe sequentienummervergelijking tussen twee gelijktijdige captures aantoont waar in het pad pakketten verdwijnen of te laat aankomen. Mist een pakket al bij de switch-capture maar niet bij het endpoint, dan ligt de oorzaak verderop in het netwerk; is het precies andersom, dan wijst dat richting het lokale LAN-segment.
Sluit voordat je conclusies trekt twee veelvoorkomende valkuilen uit. NAT- of firewall-asymmetrie kan pakketten langs een ander pad laten reizen dan je verwacht, wat de vergelijking tussen captures vertroebelt. Codec-gerelateerde problemen, zoals een mismatch in sample rate of een transcodering onderweg, kunnen ook klinken als jitter terwijl de oorzaak eigenlijk bij de audio-encoding ligt.
Pro-tip: bewaar altijd de ruwe pcap-bestanden naast je conclusies, zodat een collega de analyse later kan herhalen zonder het probleem opnieuw te moeten reproduceren.
Een paar herkenbare patronen: constante lage jitter met incidentele pieken wijst vaak op periodieke congestie, terwijl gelijkmatig hoge jitter over de hele sessie vaker een structureel QoS- of routeringsprobleem verraadt.
Concrete oplossingen: QoS, wachtrijen, uplink en jitterbufferbeleid
Zodra je de locatie van het probleem kent, draait de oplossing bijna altijd om prioritering vóór de bottleneck. Cisco’s analyse van jitter in spraaknetwerken wijst congestie, onjuiste wachtrijconfiguratie en verkeerde QoS-markering aan als de belangrijkste oorzaken, en de oplossing zit in het netwerk, niet in de telefoon.
Begin met DSCP EF (Expedited Forwarding) correct toe te wijzen aan RTP-verkeer en controleer of switches en routers die markering ook daadwerkelijk respecteren in hun wachtrijconfiguratie. Een veelgemaakte fout is dat andere applicaties, zoals een backup-taak of een videostream, ook EF claimen en daardoor de voorrang van spraak tenietdoen.
- Controleer of QoS wordt toegepast vóór de echte bottleneck, meestal de uplink naar de internetprovider, en niet alleen binnen het interne LAN.
- Reken de serialization delay van je accesslink mee: op een trage uplink duurt het verzenden van een groot pakket zelf al merkbaar lang, wat spraak kan vertragen zelfs zonder congestie elsewhere.
- Beoordeel de uploadcapaciteit los van de downloadcapaciteit, want een snelle download verbergt vaak een verzadigde upload die spraak laat haperen.
Pro-tip: een snelle verbinding garandeert geen stabiele VoIP-kwaliteit als uploadverkeer van andere diensten de wachtrij blokkeert; voorspelbare wachttijd telt zwaarder dan maximale bandbreedte.
Overweeg traffic shaping of een grotere uplink pas nadat je hebt vastgesteld dat de bottleneck daadwerkelijk op dat punt zit, niet als eerste reflex. Voor de jitterbuffer geldt een vergelijkbare terughoudendheid: vergroot die pas als tijdelijke compensatie, nooit als structurele oplossing, omdat elke vergroting de one-way delay optelt bij wat ITU-T G.114 als acceptabele planningswaarde hanteert.
Routeringsinstabiliteit, zoals wisselende ECMP-paden of een provider die regelmatig van route wisselt, kan dezelfde symptomen geven als lokale congestie. Zodra je dit patroon herkent in je captures, is het moment om de provider te betrekken met concrete tijdstempels en call-ID’s, in plaats van alleen te melden dat “bellen slecht gaat”.
Loop voor de volledigheid de configuratiebasis nog eens langs: controleer ACL’s en NAT-regels op onbedoelde blokkades van RTP-poorten, verifieer firewallregels voor SIP-ALG-gedrag, en bekijk de interface-wachtrijstatistieken op drops tijdens piekuren.
Verifiëren en monitoren: RTCP/XR, continue tests en alerts
Een eenmalige meting bewijst dat het probleem er was, niet dat het weg blijft. RTCP XR, gespecificeerd in RFC 5093, voegt rapportagevelden toe zoals vmaxdiff, vrange, jbevents en degraded seconds, die endpoint-gestuurde inzage geven in jitterbuffer-gedrag die een eenvoudige ping niet biedt.
Voor doorlopende controle werkt een combinatie van synthetische testgesprekken en periodieke geautomatiseerde captures goed: plan een vast testgesprek op momenten van piekbelasting en vergelijk de resultaten week na week.
- Monitor aanhoudend verhoogde jitter boven de praktische drempel als eerste waarschuwingssignaal.
- Houd een stijgende trend in packet loss apart bij, ook als die nog onder de 1% blijft.
- Let op frequente jitterbuffer-adaptaties, want die wijzen op onderliggende netwerkinstabiliteit die de buffer probeert te verbloemen.
Koppel deze telemetrie altijd terug aan de concrete klacht van een gebruiker. Een alert zonder context levert ruis op; een alert die je direct kunt matchen aan “extensie 204, dinsdag 14:10” bespaart je de helft van de diagnosetijd bij de volgende melding.
Praktische checklist en ervaring: hoe NLXS VoIP-jitter structureel voorkomt
Bij NLXS lossen we ICT-problemen doorgaans binnen één dag op, en die snelheid geldt ook voor verstoringen in VoIP-kwaliteit. Onze aanpak begint met een scan die netwerkinrichting en QoS-configuratie in kaart brengt voordat problemen escaleren, aangevuld met periodieke controles op belastingpieken. Voor netwerkbeheer hanteren we een checklist zoals hierboven beschreven: QoS-validatie vóór uitrol, gestructureerde capture-respons bij meldingen en vaste aanspreekpunten die rechtstreeks bereikbaar zijn zonder tussenkomst van een callcenter.
Auteursperspectief: prioriteiten en veelgemaakte fouten
De grootste fout die ik netwerkteams zie maken, is vertrouwen op één meting vanaf de router en die als waarheid behandelen. Verifieer altijd met een endpoint-capture erbij, want daar hoort de gebruiker het probleem daadwerkelijk.
Wees ook terughoudend met het reflexmatig vergroten van de jitterbuffer zodra een klacht binnenkomt. Het verbergt het symptoom en voegt vertraging toe, terwijl de echte oorzaak meestal in de wachtrijconfiguratie of de uplink zit. Samenwerking met je provider is vaker het beslissende element dan interne netwerkteams beseffen, zeker bij routeringsinstabiliteit die je zelf niet kunt bijstellen.
— Ken
Aanbod: NLXS’ VoIP- en netwerkdienst als structurele oplossing

Wij nemen de dagelijkse zorg voor stabiele spraakkwaliteit van je af, zodat jouw IT-team niet telkens zelf captures moet draaien bij elke klacht. Onze VoIP-telefonie wordt gecombineerd met doorlopend netwerkbeheer, waarbij we QoS-configuratie, uplinkbelasting en jitterbuffer-instellingen bewaken voordat ze tot klachten leiden.
- Monitoring en beheer van je netwerk inclusief QoS-validatie voor spraakverkeer.
- Snelle interventie bij meldingen, met reproduceerbare diagnose binnen hetzelfde werkdag.
- Een vrijblijvende ICT-scan om je huidige VoIP-stabiliteit in kaart te brengen.
Voor operationele telefonieprocessen rond opvolging, zoals het inrichten van voicemailstrategie naast je VoIP-omgeving, biedt Repositive’s artikel over voicemailstrategie praktische aanvullende inzichten. Plan een kennismaking via Nlxs en we brengen samen in kaart waar jouw netwerk de grootste winst kan boeken.
Veelgestelde vragen
Wat is het verschil tussen jitter en latency bij VoIP?
Latency is de totale tijd die een pakket nodig heeft om van zender naar ontvanger te reizen, terwijl jitter de variatie tussen opeenvolgende pakketten beschrijft. RIPE definieert jitter als IPDV, de variatie in vertraging van unidirectionele pakketten, wat iets anders is dan een constant hoge of lage vertraging.
Welke jitterwaarde is nog acceptabel voor VoIP-gesprekken?
Een praktische werkgrens is jitter onder 30 ms, zoals Cisco’s troubleshooting-richtlijn voor Catalyst-switches aangeeft, gecombineerd met minder dan 1% pakketverlies. Op draadloze verbindingen ligt de werkbare tolerantie doorgaans lager door extra interferentie en roaming.
Hoe gebruik ik Wireshark om VoIP-jitter te diagnosticeren?
Maak gelijktijdige captures op het endpoint en de netwerkswitch, open vervolgens Telefonie > RTP > RTP Stream Analysis in Wireshark om jitter en verlies per gesprek te zien. Cisco’s Jabber-troubleshootinggids beschrijft deze workflow inclusief het gebruik van de RTP Player om het gesprek te beluisteren.
Helpt het vergroten van de jitterbuffer altijd tegen jitter?
Een grotere jitterbuffer vangt variatie op, maar verhoogt ook de one-way delay van het gesprek, wat de spraakkwaliteit op een andere manier kan schaden. Zie het daarom als tijdelijke compensatie terwijl je de onderliggende netwerkoorzaak, zoals congestie of verkeerde QoS-mapping, oplost.
Hoe stel ik vast of mijn provider verantwoordelijk is voor jitterproblemen?
Vergelijk sequentienummers tussen gelijktijdige captures vóór en na de uplink om te zien of verlies of vertraging al ontstaat binnen je eigen netwerk of pas erna. Blijkt het probleem consistent voorbij je eigen router te ontstaan, dan is dat het moment om de provider te betrekken met concrete tijdstempels en call-ID’s.
Bronnen
- What is IP packet delay variation (IPDV) — RIPE
- Troubleshoot Jabber audio issues with Wireshark — Cisco
- RTCP XR (Extended Reports) — RFC 5093
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.