


RPO en RTO uitgelegd: praktisch stappenplan voor professionals
RTO (Recovery Time Objective) is de maximale tijd die jouw organisatie accepteert voordat een systeem na een storing weer operationeel is. RPO (Recovery Point Objective) is het maximale dataverlies dat je accepteert, uitgedrukt in tijd: hoeveel uur of minuten aan transacties mag je kwijtraken? Zet die twee cijfers vandaag nog vast voor elke kritische dienst.
- RTO: “Ons CRM moet binnen enkele uren weer werken na een uitval.”
- RPO: “We accepteren maximaal een beperkte hoeveelheid aan verloren orderdata.”
- Eerste stap: Kies één kritische dienst, vraag je directie wat de maximale uitvaltijd en het maximale dataverlies is, en schrijf die getallen op. Dat is het begin van je continuïteitsbeleid.
Beide begrippen zijn geen technische details voor de IT-afdeling alleen. Ze zijn zakelijke keuzes die bepalen hoeveel geld, klanten en reputatie je op het spel zet bij een incident. FidelSec benadrukt dat het bestuur deze doelen moet vaststellen en dat de technische inrichting daarop aansluit, niet andersom.
Belangrijkste inzichten
RTO en RPO zijn zakelijke keuzes die het bestuur moet vaststellen, met de technische inrichting als uitvoering van die keuzes, niet andersom.
| Punt | Details |
|---|---|
| RTO en RPO zijn bestuursbeslissingen | Laat de directie tekenen onder de vastgestelde doelen, niet alleen de IT-manager. |
| RTO omvat het volledige herstelproces | Detectie, restore, afhankelijkheidsherstel en verificatie tellen allemaal mee in de hersteltijd. |
| Test minstens per kwartaal voor kritische systemen | Alleen een volledige failover-test bewijst dat de afgesproken RTO en RPO haalbaar zijn. |
| Leg RTO en RPO per dienst vast in de SLA | Inclusief meetmethode, testfrequentie, bewijsplicht en escalatieprocedure. |
| NLXS biedt een gratis ICT-scan | Hiermee breng je snel in kaart of jouw huidige omgeving de gestelde continuïteitsdoelen haalt. |
Inhoudsopgave
- Wat is RPO en wat is RTO? Heldere definities voor niet-IT’ers
- Wat betekenen verschillende RTO/RPO-niveaus in de praktijk?
- Wat is het praktische verschil tussen RPO en RTO, en waarom worden ze verward?
- Waarom raken downtime en dataverlies direct je omzet en reputatie?
- Hoe bepaal je stap voor stap RTO en RPO voor jouw organisatie?
- Wat leg je concreet vast in contracten en SLA’s met leveranciers?
- Hoe controleer je of de afgesproken RTO en RPO ook echt haalbaar zijn?
- Welke aanverwante meetwaarden horen bij RTO en RPO?
- Snel referentieoverzicht: aanbevolen RTO/RPO per systeemtype
- Welke concrete taken kan een ICT-partner overnemen bij RTO en RPO?
- Waar verbeteren teams het meest als ze RTO en RPO serieus nemen?
- NLXS helpt je RTO en RPO concreet te maken
- Bronnen
Wat is RPO en wat is RTO? Heldere definities voor niet-IT’ers
Recovery Point Objective (RPO) is de maximale hoeveelheid data die je bereid bent te verliezen bij een calamiteit, gemeten in tijd. Als je RPO 2 uur is, mag je back-up maximaal 2 uur oud zijn op het moment van herstel. Alles wat in die 2 uur is ingevoerd, is dan weg.
Recovery Time Objective (RTO) is de maximale tijd die mag verstrijken tussen het moment van uitval en het moment waarop de dienst volledig operationeel is. Microsoft benadrukt dat RTO het volledige herstelproces omvat: detectie van het probleem, het starten van herstelacties, terugzetten van data, herstellen van afhankelijkheden en verificatie dat eindgebruikers weer kunnen werken. Het is dus veel meer dan alleen “een back-up terugzetten.”.
- RPO-voorbeeld: Een boekhoudpakket met RPO = 24 uur betekent dat dagelijkse back-ups volstaan. Verlies je een dag werk, dan is dat acceptabel.
- RTO-voorbeeld: Een webshop met RTO = 2 uur moet binnen 2 uur na een servercrash weer bestellingen kunnen verwerken, inclusief alle herstelstappen.
Pro-tip: Vraag bij elke dienst twee vragen: “Hoelang mogen we uitvallen?” (RTO) en “Hoeveel data mogen we kwijtraken?” (RPO). Die twee antwoorden zijn je startpunt voor elke technische keuze.
Wat betekenen verschillende RTO/RPO-niveaus in de praktijk?
De onderstaande scenario’s laten zien welk concreet effect een bepaalde RTO of RPO heeft voor typische mkb-systemen, en welke technische aanpak daarbij past. BosmanICTServices koppelt systeemtypen aan oplossingscategorieën zoals cold, warm en hot sites, inclusief kostenimpact.
| Systeem | Voorgestelde RPO | Voorgestelde RTO | Technische oplossing | Kosten/beschikbaarheid |
|---|---|---|---|---|
| Webshop (bestellingen) | Zeer korte RPO | Korte RTO | Hot site, continue replicatie | Hoog, hoge beschikbaarheid |
| CRM / klantendata | Korte RPO | Enkele uren RTO | Warm site, uurlijkse snapshots | Gemiddeld |
| Financiële verwerking | Korte RPO | Korte RTO | Warm/hot site, synchrone back-up | Hoog |
| Archief / documentbeheer | Lange RPO | Lange RTO | Cold site, dagelijkse back-up | Laag, beperkte beschikbaarheid |
Hoe agressiever je RTO en RPO, hoe hoger de kosten. Een webshop die elke minuut omzet draait, rechtvaardigt een hot site met continue replicatie. Een documentarchief dat zelden wordt geraadpleegd, kan prima met een dagelijkse back-up toe. De kunst is de juiste balans vinden per systeem, niet één aanpak voor alles.
Wat is het praktische verschil tussen RPO en RTO, en waarom worden ze verward?
De verwarring ontstaat doordat beide begrippen over herstel gaan, maar ze meten in tegengestelde richtingen. SentinelOne legt het kernverschil helder uit: RTO meet vooruit (hoeveel tijd heb je om te herstellen?), RPO meet achteruit (hoe ver terug in de tijd mag je herstelpunt liggen?).
Drie veelvoorkomende misverstanden:
- “RTO en RPO zijn hetzelfde.” Niet juist. Een systeem kan een RTO van 4 uur hebben en een RPO van 15 minuten. Dat betekent: je hebt 4 uur om te herstellen, maar de data mag maximaal 15 minuten oud zijn. Twee onafhankelijke doelen.
- “Een goede back-up is genoeg voor een lage RTO.” Onjuist. Back-ups herstellen data, maar de tijd om een server op te starten, afhankelijkheden te herstellen en te verifiëren telt ook mee. Microsoft maakt duidelijk dat RTO het volledige herstelproces omvat, niet alleen de restore-actie.
- “RPO en RTO stel je eenmalig in.” In werkelijkheid veranderen systemen, transactievolumes en risico’s. Jaarlijkse herziening is minimaal.
Kosten versus risico: Near-zero RPO vereist continue of synchrone replicatie. Near-zero RTO vereist een actief-actieve architectuur waarbij twee omgevingen tegelijk draaien. Beide samen zijn kostbaar en vragen expliciete goedkeuring van de directie, niet alleen van IT.
Waarom raken downtime en dataverlies direct je omzet en reputatie?
RTO en RPO zijn geen abstracte IT-parameters. Ze bepalen concreet wat er op het spel staat als er iets misgaat. Elke minuut dat een webshop offline is, kost directe omzet. Kijk voor concrete kostenberekeningen bij webshop downtime-voorbeelden om te zien wat uitval in de praktijk betekent voor mkb-bedrijven.
Criteria om systemen te prioriteren:
- Financieel: Hoeveel omzet of transacties verwerk je per uur? Een betaalsysteem dat € 5.000 per uur verwerkt, heeft een andere prioriteit dan een intern planningssysteem.
- Juridisch en compliance: Sommige sectoren (zorg, financiën) hebben wettelijke eisen voor dataverlies en hersteltijden. Niet voldoen kan boetes of aansprakelijkheid opleveren.
- Operationeel: Welke systemen blokkeren andere processen als ze uitvallen? Een CRM-storing die ook de klantenservice en facturatie platlegt, heeft een kettingeffect.
Betrek bij het vaststellen van RTO en RPO altijd drie partijen: de directie (stelt risicobereidheid vast), de proceseigenaar (kent de operationele impact) en IT (beoordeelt technische haalbaarheid en kosten). Zonder die drie aan tafel krijg je doelen die óf onrealistisch ambitieus zijn óf te laag gegrepen.
Hoe bepaal je stap voor stap RTO en RPO voor jouw organisatie?
Een gestructureerde aanpak voorkomt dat je willekeurige getallen invult. Volg deze stappen:
- Voer een Business Impact Analyse (BIA) uit. Inventariseer alle systemen en processen. Stel per systeem vast: wat is de financiële schade per uur uitval, welke processen stoppen, en wat zijn de juridische verplichtingen? Transactievolumes en reconstructiekosten per verloren uur zijn je kwantitatieve basis voor RPO.
- Classificeer diensten en data. Deel systemen in naar kriticaliteit: kritisch (direct omzetverlies of wettelijke verplichting), belangrijk (operationele hinder) en ondersteunend (beperkte impact). Elke categorie krijgt een eigen RTO/RPO-bandbreedte.
- Bepaal MTD en leid RTO af. MTD (Maximum Tolerable Downtime) is de absolute grens waarboven de organisatie ernstige schade lijdt. Stel RTO altijd lager in dan MTD. SentinelOne adviseert de kosten van snellere herstelmiddelen af te zetten tegen de kosten van aanhoudende uitval, en het optimale snijpunt te kiezen.
- Bepaal RPO op basis van wijzigingssnelheid en reconstructiekosten. Hoe snel verandert de data? Een orderverwerking die elke minuut nieuwe transacties ontvangt, vraagt een kortere RPO dan een archief dat wekelijks wordt bijgewerkt. Bereken wat het kost om verloren data handmatig te reconstrueren en vergelijk dat met de kosten van frequentere back-ups.
Voorbeeldberekening: Een webshop verwerkt gemiddeld 20 bestellingen per uur à € 75 gemiddelde orderwaarde. Eén uur dataverlies kost € 1.500 aan niet-herstelbare orders. Een uurlijkse back-up kost € 50 per maand extra. De keuze voor RPO = 1 uur is dan financieel direct te rechtvaardigen.
- Leg de vastgestelde RTO en RPO schriftelijk vast per systeem.
- Laat de directie of een aangewezen bestuurder de doelen formeel goedkeuren.
- Koppel elk doel aan een verantwoordelijke proceseigenaar.
Pro-tip: Laat niet alleen de IT-manager tekenen. Een RTO of RPO is een zakelijke beslissing over risicobereidheid. De handtekening van een directielid maakt duidelijk dat het bestuur de consequenties kent en accepteert.
Wat leg je concreet vast in contracten en SLA’s met leveranciers?
Een mondelinge afspraak over herstel is niets waard als er een incident is. Transfer Solutions adviseert RPO en RTO per dienst expliciet vast te leggen en regelmatig te testen om continuïteitsafspraken aantoonbaar te maken.
Zorg dat de volgende elementen in elke SLA staan:
- De exacte RTO-waarde per dienst of systeem, inclusief wat “operationeel” betekent (alleen server aan, of ook applicatie en data geverifieerd?).
- De exacte RPO-waarde, inclusief de meetmethode (tijdstempel van laatste geverifieerde back-up).
- Testfrequentie: hoe vaak voert de leverancier een hersteltest uit en wie ontvangt het rapport?
- Escalatieprocedure: wie wordt wanneer gebeld, en wat zijn de stappen als RTO of RPO dreigt te worden overschreden?
- Bewijsplicht: de leverancier levert aantoonbaar bewijs (testrapport, logbestanden) dat de afgesproken doelen haalbaar zijn.
Voorbeeldclausule (conceptueel): “Leverancier garandeert een RTO van maximaal 4 uur en een RPO van maximaal 1 uur voor de productieomgeving, aantoonbaar gemaakt door kwartaalrapportages van uitgevoerde hersteltests.”
- Vraag bij elke offerte om een testrapport van de laatste hersteltest.
- Controleer of de SLA een boetebepaling bevat bij structurele overschrijding van RTO of RPO.
- Leg de rapportagefrequentie vast: maandelijks of per kwartaal.
- Zorg dat de SLA aangeeft wie verantwoordelijk is voor monitoring en alertering.
Hoe controleer je of de afgesproken RTO en RPO ook echt haalbaar zijn?
Afspraken op papier zijn pas geloofwaardig als ze zijn getest. Transfer Solutions stelt dat regelmatige failover-oefeningen en verificatie van back-upintegriteit het enige echte bewijs zijn dat SLA-parameters worden gehaald.
Het verschil tussen twee testvormen is groot:
- Back-upverificatie: Controleer of de back-up leesbaar en volledig is. Dit bewijst dat data beschikbaar is, maar zegt niets over hoe lang herstel duurt.
- Volledige failover-test: Simuleer een echte uitval en meet de tijd van detectie tot volledig operationeel systeem. Dit is de enige manier om RTO werkelijk te toetsen.
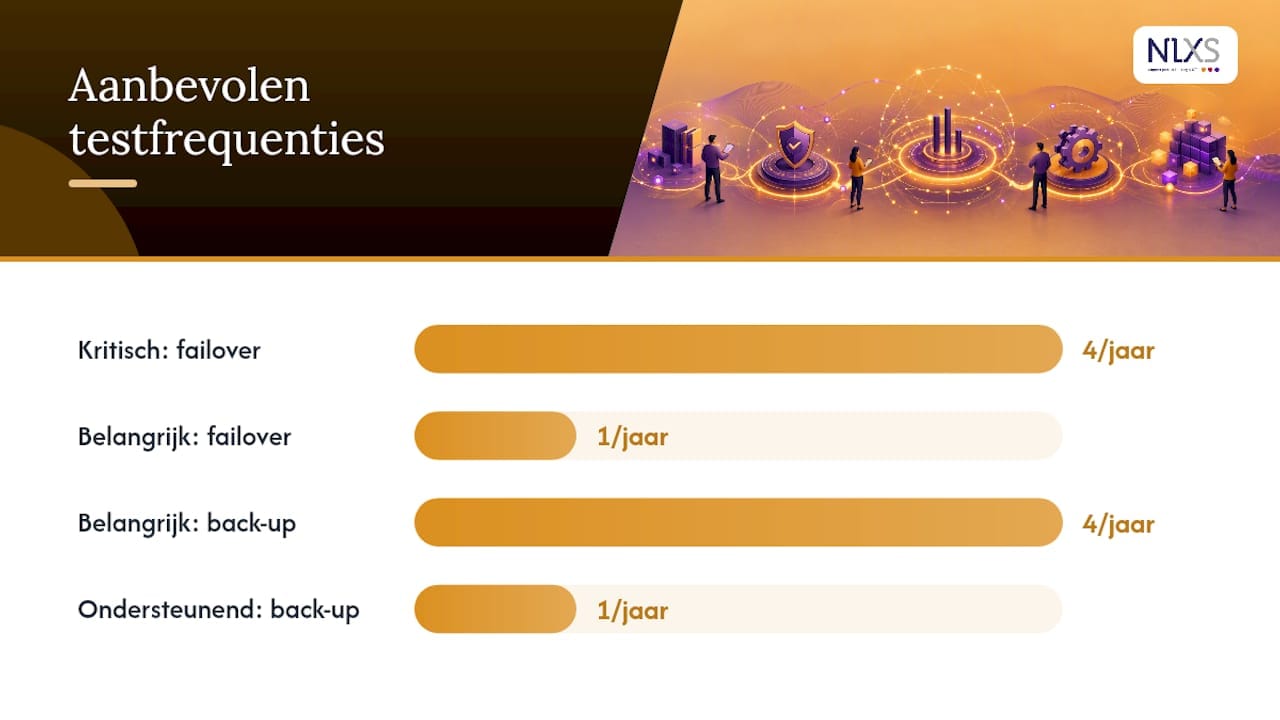
Aanbevolen testfrequenties:
- Kritische systemen: volledige failover-test minimaal één keer per kwartaal.
- Belangrijke systemen: jaarlijkse volledige test, kwartaalmatige back-upverificatie.
- Ondersteunende systemen: jaarlijkse back-upverificatie.
Meetpunten tijdens een test: tijdstip van detectie, tijdstip van start herstelactie, tijdstip van eerste data beschikbaar, tijdstip van volledige operationele status. Leg alle tijden vast in een testrapport.
Pro-tip: Ransomware-incidenten verlengen de RTO aanzienlijk, omdat herstel ook forensische verificatie en opschoning van besmette back-ups vereist. Neem dit scenario expliciet op in je testplan, niet alleen de klassieke hardwarestoring.
Meer over back-uparchitectuur voor het mkb vind je in de cloudbackup- en snelherstelgids.
Welke aanverwante meetwaarden horen bij RTO en RPO?
Naast RTO en RPO zijn er twee meetwaarden die je continuïteitsbeleid completer maken:
- MTTR (Mean Time To Repair): De gemiddelde tijd die nodig is om een storing te verhelpen. MTTR en RTO overlappen deels, maar MTTR is een historisch gemiddelde over meerdere incidenten. Als je MTTR structureel hoger is dan je RTO, heb je een probleem dat je technisch of organisatorisch moet oplossen.
- MTBF (Mean Time Between Failures): De gemiddelde tijd tussen twee storingen. Een lage MTBF betekent dat systemen vaak uitvallen, wat de kans vergroot dat je RTO of RPO daadwerkelijk wordt aangesproken.
MTTR gebruik je bij het evalueren van testen: meet je werkelijke hersteltijd per incident en vergelijk die met de afgesproken RTO. MTBF gebruik je bij capaciteitsplanning en risicobeoordeling.
Voor managementrapportage zijn de vier meest informatieve meetwaarden: RTO (doel), MTTR (werkelijkheid), RPO (doel) en de tijdstempel van de laatste geverifieerde back-up (werkelijkheid). Die vier samen geven een directie een eerlijk beeld van de continuïteitsstatus.
Snel referentieoverzicht: aanbevolen RTO/RPO per systeemtype
Gebruik dit template als startpunt voor je BIA-document of SLA-gesprekken. Pas de waarden aan op basis van jouw eigen BIA-uitkomsten.
Wie tekent de goedkeuring per niveau:
- Kritisch systeem (RPO < 1 uur, RTO < 2 uur): directie of bestuurder.
- Belangrijk systeem (RPO 1–8 uur, RTO 2–8 uur): proceseigenaar met directieparaaf.
- Ondersteunend systeem (RPO > 8 uur, RTO > 8 uur): IT-manager of operationeel verantwoordelijke.
Voor een praktische back-upstrategie per systeemtype biedt de data back-up gids voor mkb aanvullende stappen.
Welke concrete taken kan een ICT-partner overnemen bij RTO en RPO?
Een goede ICT-partner voert niet alleen technische taken uit. Hij helpt je ook de zakelijke kant te structureren. Concrete dienstverlening die een partner kan leveren:
- BIA uitvoeren: Inventariseren van systemen, transactievolumes en reconstructiekosten per dienst.
- Back-uparchitectuur ontwerpen: Keuze tussen cold, warm en hot site op basis van jouw RPO-doelen.
- Replicatie inrichten: Continue of synchrone replicatie voor kritische systemen met lage RPO.
- Failover-tests uitvoeren: Gecontroleerde simulaties met meetbare resultaten en een testrapport.
- Continue monitoring: Alertering bij back-upfouten, integriteitsproblemen of dreigende overschrijding van hersteldoelen.
Vragen die je een potentiële partner moet stellen:
- Kun je een testrapport van de laatste failover-test laten zien?
- Hoe bewijs je dat mijn RPO en RTO haalbaar zijn, niet alleen op papier?
- Wat is jouw eigen RTO als jouw infrastructuur uitvalt?
- Heb je referenties van klanten met vergelijkbare continuïteitseisen?
De oorzaak: een afhankelijkheid van een externe DNS-provider was niet meegenomen in het herstelplan. Dat soort blinde vlekken vind je alleen door te testen, niet door te vertrouwen op papieren garanties. Meer over managed ICT-diensten voor mkb laat zien hoe beheerde dienstverlening continuïteit structureel ondersteunt.
Waar verbeteren teams het meest als ze RTO en RPO serieus nemen?
De grootste winst zit zelden in de techniek. Organisaties die RTO en RPO echt verbeteren, doen dat door twee dingen anders te doen.
Ten eerste: ze halen het onderwerp uit de IT-afdeling en leggen het op de bestuurstafel. Zolang RTO en RPO alleen in een technisch document staan dat niemand buiten IT leest, zijn het lege getallen. Zodra een directeur tekent onder een RPO van 1 uur voor de orderverwerking, verandert de prioriteit van het hele herstelplan.
Ten tweede: ze testen vaker dan ze denken nodig te hebben. Eén jaarlijkse test geeft een momentopname. Kwartaaltests laten zien of wijzigingen in de infrastructuur, nieuwe software of groeiend datavolume de hersteltijd hebben beïnvloed. Kleine aanpassingen die tussendoor worden doorgevoerd, kunnen onverwacht grote gevolgen hebben voor de werkelijke RTO.
Pro-tip: Begin klein. Kies één kritisch systeem, voer een volledige failover-test uit en meet de werkelijke hersteltijd. Vergelijk die met je afgesproken RTO. Dat ene getal vertelt je meer dan een jaar aan theoretische planning.
NLXS helpt je RTO en RPO concreet te maken
Weten wat RTO en RPO zijn is één ding. Weten of jouw huidige ICT-omgeving die doelen ook werkelijk haalt, is een andere vraag. NLXS voert voor mkb-bedrijven een gratis ICT-scan uit die precies dat inzichtelijk maakt: welke systemen zijn kritisch, wat zijn de werkelijke hersteltijden, en waar zitten de risico’s in je huidige back-up- en herstelarchitectuur.

Waar andere partijen je doorverwijzen naar een lang traject, levert NLXS binnen één dag een helder beeld van je continuïteitssituatie. Geen verrassingen achteraf, geen technisch jargon zonder uitleg. Van ICT-scan tot beheerde back-ups en failover-tests: NLXS regelt het zodat jij je kunt richten op je bedrijf. Bekijk de ICT-diensten van NLXS of plan direct je scan via de scanpagina.
Bronnen
Betrouwbare bronnen voor verdere verdieping in RTO, RPO en bedrijfscontinuïteit:
- Reliability metrics – Microsoft Learn
- RTO en RPO en business continuity: hoe lang kun jij je IT missen? – FidelSec
- RPO en RTO: wanneer continuïteit concreet wordt – Transfer Solutions
- RTO vs RPO: Belangrijkste Verschillen in Disaster Recovery Planning – SentinelOne
- RPO en RTO: Back-up strategieën uitgelegd – BosmanICTServices
Reacties0
Nog geen reacties
Deel als eerste uw gedachten.
Meld u aan of registreer u om een reactie te plaatsen.